Proof of Delivery (POD) automatisieren: Software- vs. Hybridlösungen
Proof of Delivery (POD) automatisieren: Software- vs. Hybridlösungen
Eine langsame POD-Verarbeitung friert Ihre Liquidität ein
Die verzögerte Verarbeitung von Frachtbriefen blockiert den Fakturierungszyklus und treibt die Days Sales Outstanding (DSO) in die Höhe. Unstrukturierte Daten wie verschwommene Stempel auf Papierdokumenten oder schlecht beleuchtete Scans von Subunternehmern bremsen den Cashflow unmittelbar. Jeder Tag, an dem ein Proof of Delivery (POD) unbearbeitet in einem Posteingang oder einer physischen Ablage liegt, ist ein Tag, an dem eine abgeschlossene Fahrt unbezahlt bleibt. Ein effizientes Backoffice-Outsourcing für die Logistikbranche ist hierbei essenziell, um diese Prozesse zu beschleunigen.
Laut der Publikation „Proof of Delivery System: Eliminate Billing Delays Instantly“ von Withvector führt die Unfähigkeit, Liefernachweise sofort mit Rechnungen zu verknüpfen, zu Liquiditätsengpässen. Physische Dokumente mit unleserlichen Unterschriften, fehlenden Referenznummern oder Kaffeeflecken erfordern manuelle Nachforschungen. Spediteure und Transportunternehmen finanzieren in der Zwischenzeit Treibstoff, Mautgebühren und Gehälter vor. Eine schnelle Datenverarbeitung ist eine finanzielle Notwendigkeit, um die operativen Margen zu schützen.
Die Grenzen von 100 % automatisierter POD-Software (OCR/KI)
Standardmäßige OCR- (Optical Character Recognition) und KI-Software erreicht bei standardisierten, digital erstellten Dokumenten eine hohe Genauigkeit. Die Grenze dieser Technologie liegt jedoch bei physischen CMR-Frachtbriefen. Sobald ein Dokument durch handschriftliche Fahrernotizen, Stempel über gedrucktem Text oder physische Beschädigungen von der Norm abweicht, sinkt die Erkennungsrate drastisch. Dadurch werden die Einschränkungen einer vollständigen Automatisierung in einem dynamischen Transportumfeld schmerzlich deutlich.
Die raue Realität der Supply Chain
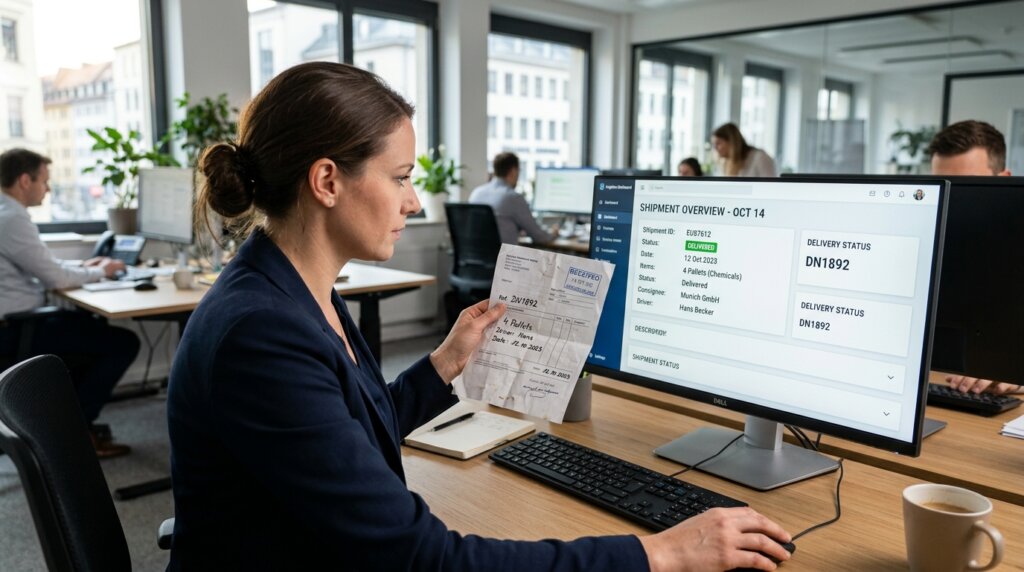
In der Theorie geht man von einem sauberen, digitalen PDF aus. In der Praxis der Supply Chain handelt es sich jedoch oft um einen zerknitterten, fettfleckigen physischen Frachtbrief, der von einem Fahrer in einer schlecht beleuchteten Fahrerkabine abfotografiert wurde. Dokumentationen von Klippa über ihre „Proof of Delivery OCR – Data Extraction API“ sowie die Erkenntnisse von Verityteknologi in „Digitizing Logistics Documents“ unterstreichen die enorme Varianz der Quelldateien. Qualitätsverluste durch schlechte Lichtverhältnisse, schiefe Aufnahmewinkel und Kamerarauschen führen dazu, dass rein technologische Lösungen spezifische Datenpunkte nicht zuverlässig validieren können.
Die verborgene Last des internen Exception Handlings
Eine geringe Genauigkeit bei der Datenextraktion führt zu einem Anstieg des Exception Handlings durch interne Mitarbeiter. Wenn der Software-Algorithmus ein Datenfeld nicht mit Sicherheit auslesen kann, markiert das System dieses zur manuellen Überprüfung. Die Arbeitslast verlagert sich somit in das interne Backoffice, anstatt es zu entlasten. Die Mitarbeiter verbringen ihre Zeit damit, Ausgabefehler zu entziffern und zu korrigieren. Dieser verdeckte Aufwand macht die geplante Zeitersparnis durch die Softwarelizenzen zunichte und verzögert den Fakturierungsprozess letztendlich doch.
Wie ein hybrides Modell (Technologie + Mensch) die Fehlerquote minimiert
Die Kombination aus Technologie und gezielter menschlicher Validierung bietet Skalierbarkeit und fängt die Unzulänglichkeiten reiner Softwarelösungen auf. Wo Algorithmen an imperfekten Logistikdaten scheitern, sorgt menschliches Urteilsvermögen für eine korrekte Abwicklung.
Human-in-the-Loop (HITL) als Qualitätssicherung
Der Human-in-the-Loop (HITL) Ansatz basiert auf einer strikten Aufgabenverteilung, um maximale Effizienz zu gewährleisten. Die KI- und OCR-Technologie übernimmt die Hauptarbeit: die Klassifizierung von Dokumententypen und die Extraktion von maschinengeschriebenen, gut lesbaren Daten. Der menschliche Spezialist überprüft ausschließlich die sogenannten „Low-Confidence“-Felder, die das System nicht eindeutig verarbeiten kann.
Die Publikation „Proof of Delivery Data Extraction: Fields and Workflow“ (Invoice Data Extraction) und die arXiv-Studie „MADP: A Multi-Agent Pipeline for Sustainable Document Processing“ untermauern die Wirksamkeit dieser Aufgabenteilung. Erkenntnisse aus dem Leitfaden „Human-in-the-Loop Document Processing“ (IDP-Software) bestätigen die hohe Genauigkeit der menschlichen Aufsicht bei beschädigten Dokumenten, ohne die interne Organisation mit zeitaufwendigen Recherchen zu belasten.
Strukturelle Verbesserung durch kontinuierliches Feedback
HITL endet nicht bei der Behebung einer akuten Ausnahme. Jede manuelle Korrektur fließt als Feedback in das zugrundeliegende Machine-Learning-Modell ein. Datenverarbeitungsspezialisten annotieren Dokumente und korrigieren Lesefehler direkt im System. Mit diesen gelabelten Daten wird der Algorithmus trainiert. Das Modell lernt daraus und kann bei einem nachfolgenden, vergleichbaren Dokument desselben Absenders die korrekten Daten zuverlässig erkennen. Dieser Mechanismus sorgt für strukturelle und langfristige Verbesserungen in der Erkennungsrate des OCR-Systems.
Auswirkungen auf Liquidität und Betriebskosten
Die Wahl des Verarbeitungsmodells hat direkte Konsequenzen für die operativen Budgets und das Betriebskapital einer Organisation.
Feste Lizenzkosten versus skalierbare volumenbasierte Abrechnung
Reine Softwarelösungen erfordern hohe Anfangsinvestitionen für die Implementierung, laufende Lizenzgebühren und interne Personalkosten (FTE) für das Exception Handling. Dies wird in der Analyse „Digital Proof of Delivery Software — Automated ePOD“ von Traqo deutlich hervorgehoben. Starre Softwareverträge zwingen Unternehmen zudem dazu, für Kapazitäten zu zahlen, die außerhalb von saisonalen Spitzenzeiten ungenutzt bleiben.
Ein hybrides BPO-Modell bietet hingegen Skalierbarkeit basierend auf dem tatsächlichen Datenvolumen. Organisationen zahlen nur für erfolgreich verarbeitete Dokumente. Dieser Ansatz gleicht Schwankungen der Frachtmengen effektiv aus, ohne dass Unternehmen feste interne Kapazitäten für Dateneingabe-Mitarbeiter vorhalten müssen.
Rechenbeispiel: DSO-Reduzierung in der Praxis
Die Fallstudie „How We Reduced DSO from 40 to 7 Days — An 81% Improvement“ von Limebox veranschaulicht den finanziellen ROI einer optimierten Dokumentenverarbeitung. Überträgt man diese Dynamik auf eine mittelständische Spedition mit einem Jahresumsatz von 25 Millionen Euro, beläuft sich der durchschnittliche Tagesumsatz in diesem Szenario auf 68.493 Euro.
Wenn manuelle Verarbeitung oder Fehler in reiner OCR-Software zu einer strukturellen Verzögerung der Rechnungsstellung führen, wird unnötig Betriebskapital gebunden. Sinkt die Days Sales Outstanding (DSO) durch eine beschleunigte und präzise hybride Dateneingabe um nur zwei Tage, stehen sofort 136.986 Euro an frei verfügbarem Betriebskapital zur Verfügung. Die Organisation kann dieses Kapital direkt investieren, anstatt es zur Überbrückung offener Forderungen blockieren zu müssen.
Entscheidungsgrundlage: Software-Only vs. Hybridlösung
Die richtige operative Entscheidung hängt von der Art der Quelldateien und der Komplexität der Lieferkette ab. Die folgende Tabelle bietet konkrete Anhaltspunkte, die unter anderem auf den Analysen „OCR in Logistics: The Complete 2025 Guide“ (Klearstack) und „Document Intelligence — AI OCR for Logistics“ (CargoMatrix) basieren.
| Kriterien | Nur Software (OCR/KI) | Hybride Lösung (BPO/HITL) |
|---|---|---|
| Anfangsinvestition | Hoch (Software-Integration, Lizenzen, Konfiguration von KI-Modellen) | Niedrig (Einrichtung nach Prozessspezifikationen, Pay-per-Use) |
| Verarbeitung physischer CMRs | Geringe Erfolgsquote bei Flecken, Falten und schlechten Scans | Hohe Erfolgsquote dank menschlicher Beurteilung von Abweichungen |
| Interne Arbeitsbelastung | Hoch (interne Kapazitäten für Exception Handling erforderlich) | Minimal (Ausnahmen werden vom externen Partner bearbeitet) |
| Genauigkeit bei Abweichungen | Algorithmus erzeugt Fehler oder blockiert die Dokumentenverarbeitung | Menschlicher Datenspezialist korrigiert Fehler und trainiert das Modell |
Organisationen, die ausschließlich mit geschlossenen digitalen Systemen und e-CMRs arbeiten, erzielen mit reinen Softwarelösungen eine ausreichende Rendite. Der Datenstrom ist in diesen Fällen stark strukturiert.
Die hybride Lösung ist jedoch speziell für Spediteure, 3PL-Transporteure und Logistikdienstleister mit fragmentierten Supply Chains positioniert. In Netzwerken mit diversen internationalen Chartern erzeugen Subunternehmer einen ständigen Strom an unstrukturierten, physischen und oft handgeschriebenen Dokumenten. In diesem Kontext ist menschliche Validierung zwingend erforderlich, um Datengenauigkeit (Data Accuracy) und Compliance zu gewährleisten.
Machen Sie den nächsten Schritt zu einem reibungslosen Fakturierungszyklus
Eine präzise Dateneingabe ist die unmittelbare Grundlage für kürzere Fakturierungszyklen und schnellere Zahlungseingänge. Die Kombination aus KI-Technologie und menschlicher Kontrolle erhöht die Datenqualität und senkt den operativen Druck auf Ihr internes Team. Erwägen Sie, Ihre logistischen Backoffice-Aufgaben über hybride BPO-Modelle und zuverlässiges Nearshoring innerhalb der EU strategisch auszulagern? Entdecken Sie, wie DataMondial spezialisierte Unterstützung für Logistikprozesse bietet, damit Ihre Dokumentenverarbeitung sicher, fehlerfrei und vollständig skalierbar gestaltet wird.