Het multimodale meetprobleem: Hoe emissiedata verdwaalt op de grens tussen schip, trein en truck
Waar de keten breekt: Van terminal naar achterland
Tijdens intermodaal transport ontstaat structureel dataverlies op het moment dat een container van modaliteit wisselt. Fysieke overslag verloopt gestroomlijnd; de datastroom volgt echter een gefragmenteerd pad. Binnen de logistieke keten overschrijden goederen de grenzen van afgesloten digitale ecosystemen, waardoor primaire emissiedata stagneert bij terminalbalies. Een professionele partner voor nauwkeurige dataverwerking helpt bedrijven om deze verloren informatie weer centraal beschikbaar te maken.
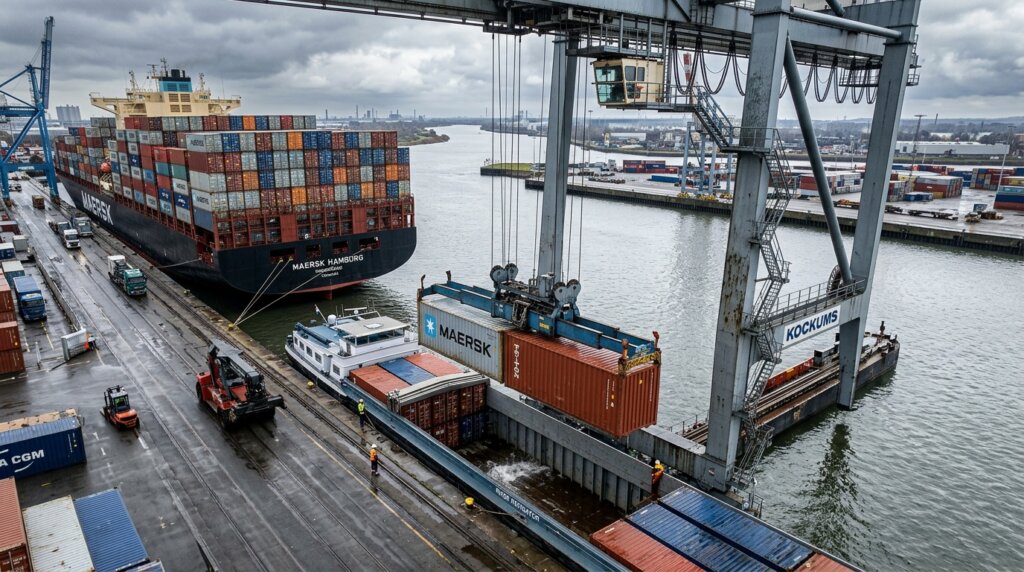
Zeevrachtdocumentatie is strak georganiseerd. Rederijen en grote terminals communiceren via gestandaardiseerde EDI-protocollen, die nauwkeurige ladinggegevens, gewichten en afstanden bevatten. Op het moment dat de container via de kadekraan de terminal of barge verlaat voor het natransport, stopt de digitale eenduidigheid. De systemen van lokale wegvervoerders en railoperators werken in uiteenlopende formaten, variërend van webportalen en losse PDF-bestanden tot de fysieke papieren CMR. In het rapport CO2 Emissions Reporting: Challenges and Opportunities for the Logistics Industry wordt deze overgang aangewezen als de primaire bron van hiaten in end-to-end carbon tracking.
Handmatige documentoverdracht en balie-afhandeling veroorzaken directe vertragingen in het verzamelen van brondata. Transportplanners wachten op chauffeurs die de papieren vrachtbrieven aan het einde van de werkweek inleveren, waardoor real-time emissieberekening blokkeert.
| Modaliteit | Typische Datastandaard | Primaire Drager | Impact op Emissie-tracking |
|---|---|---|---|
| Zeevracht | EDI of API (gestandaardiseerd) | Digitaal | Hoog: nauwkeurige integratie mogelijk |
| Binnenvaart / Rail | Divers: XML, webportalen, PDF | Digitaal / Print | Gemiddeld: vaak conversie nodig voor TMS |
| Wegtransport (lokaal) | Eigen TMS format of geen standaard | Papieren of eCMR / PDF | Laag: handmatige invoer verbreekt brondata |
De botsing tussen systeemdata en documentatie bij terminal overdracht
De kloof tussen digitale EDI-berichten en ongestructureerde lokale vrachtbrieven creëert onherleidbare gaten in transportdossiers. EDI vereist strikte veldmapping waarbij iedere datapunt — van brutogewicht tot referentienummer — exact correspondeert. Zodra het fysieke natransport start, genereert de lokale vervoerder documentatie op basis van eigen voorschriften en processen. Binnen het initiatief Digitalisation and Electronic Freight Transport Information (eFTI) wordt beschreven hoe verschillende interpretaties van documentatieverplichtingen de ketentransparantie verstoren. Een digitaal systeem aan de voorkant verwacht een naadloze datavoeding, maar ontvangt in de praktijk kopieën van douanepapieren en onvolledig ingevulde vrachtbrieven.
Verlies van het zendingsnummer
Zodra een zeecontainer overslaat op een vrachtwagen, maakt de vervoerder een nieuwe rit aan in het eigen Transport Management Systeem (TMS). De technische logica van dergelijke systemen dwingt het genereren van een nieuw, uniek rit- of referentienummer af. Dit overschrijft of negeert vaak het oorspronkelijke overkoepelende zendingsnummer. De emissiefactor van de specifieke lading raakt hierdoor losgekoppeld van de historische vrachtdata. Volgens de richtlijnen rond de Electronic Consignment Note (eCMR) – UNECE biedt digitalisering van de vrachtbrief potentie, maar een gebrek aan universele adoptie betekent dat referentienummers handmatig overgenomen moeten worden — een stap die vaak achterwege blijft of typefouten bevat.
De impact van gefragmenteerde bronnen op Scope 3
Het direct kwantificeren van operationele risico's start bij het analyseren van deze datalekken op rapportageniveau. Wanneer primaire brondata ontbreekt of onleesbaar wordt door formatwijzigingen, verplichten rapportagestandaarden zoals het GLEC Framework 2.0 bedrijven om terug te vallen op sectorgemiddelden (default values). Zonder verifieerbare logistieke activiteit op ritniveau — zoals werkelijk brandstofverbruik of het exacte laadvermogen — rekent de metodiek met conservatieve schattingen om under-reporting te voorkomen.
Dit creëert een verslechterd CO2-profiel. Bedrijven die opereren onder de Corporate Sustainability Reporting Directive (CSRD) worden afgerekend op de accuraatheid van deze emissiecijfers. Het document Frequently Asked Questions: Corporate Sustainability Reporting Directive (CSRD) verduidelijkt dat accountantsketens strikt toezien op het gebruik van gemeten brondata voor Scope 3 emissies versus benaderde waarden. Het gebrek aan koppeling dwingt backoffice-medewerkers tot tijdrovend onderzoek: routes moeten achteraf gereconstrueerd worden met behulp van losse facturen, weegbrugbonnen en e-mailverkeer om alsnog een preciezere berekening in te dienen.
Rekenvoorbeeld: Data-uitval op de route Rotterdam – Duisburg
De gevolgen van een haperende data-overdracht vertalen zich direct in onnauwkeurige CO2-voetafdrukken. Het Technical Guidance for Calculating Scope 3 Emissions – GHG Protocol en het onderzoek STREAM – Studie naar TRansport Emissies van Alle Modaliteiten (Update) leggen de basis voor emissiecalculaties waarbij het modale onderscheid de einduitslag bepaalt. Dit stappenplan illustreert het effect van data-uitval:
- Aankomst deepsea terminal Rotterdam: De zending wordt geregistreerd onder master bill of lading X123. EDI-berichten calculeren de maritieme emissie op basis van het traject Shanghai – Rotterdam rond af.
- Overslag naar binnenvaartschip: De lading (bruto 20.000 kg) reist per barge naar Duisburg. De operationele emissiefactor voor deze binnenvaart ligt qua tonkilometers laag (~20 gram CO2e/tkm).
- Data-uitval op de kade in Duisburg: Bij aankomst wordt de barge gelost. Een lokale transporteur haalt de container fysiek op met een vrachtwagen, vergezeld van een handgeschreven CMR, waarbij het originele referentienummer X123 ontbreekt.
- Calculatie met ontbrekende parameters: Aan het kwartaaleinde consolideert de verlader de gegevens. Omdat de link tussen de barge en het wegtransport verbroken is, ziet het emissiesysteem in de backoffice enkel het startpunt (Rotterdam) en het eindpunt (het magazijn in Duitsland) voor gemaakte logistieke bestellingen.
- Het resultaat — conservatieve straf: Het algoritme past de fallback-methode toe. In plaats van de efficiënte binnenvaartrit te tellen, berekent het systeem de volledige route Rotterdam-Magazijn als wegtransport (bijvoorbeeld als heavy duty truck, emissiefactor ~75 gram CO2e/tkm). De gerapporteerde Scope 3-emissies voor deze zending vallen ruim driemaal hoger uit.
De kwetsbaarheid van natransport op de spotmarkt
Data-stabiliteit verschilt drastisch per contractvorm. Vaste, langlopende logistieke contracten (dedicated fleets) maken gebruik van uniforme data-protocollen. Bij dergelijke partijen verplicht de Service Level Agreement interoperabiliteit tussen het ERP-systeem van de verlader en het TMS van de vervoerder. Primairy data wordt zo systematisch gewaarborgd.
De dynamische aard van de spotmarkt verstoort dit proces. Ad-hoc ritten worden overgelaten aan een sterk gefragmenteerde groep onderaannemers, die elk verschillende of soms zelfs afwezig zijnde TMS-oplossingen gebruiken. De data leeft hier uitsluitend op geïsoleerde dragers, wat het onmogelijk maakt om actuele emissiefactoren op te halen zonder handmatige interventie en dossierverificatie.
Waarom API-koppelingen struikelen over vrachtdocumenten
Technologische ingrepen, zoals pure API-integraties, bieden geen afdoende oplossing voor intermodaal databeheer. In gestandaardiseerde omgevingen excelleert software-koppeling, maar de heterogeniteit in externe logistieke ketens dwingt zulke systemen vaak tot stilstand.
API's zijn ontworpen om vastgestelde datastromen asynchroon te verwerken. De ongestructureerde realiteit van wereldwijde transportdocumentatie weigert in deze voorgeschreven vakjes te passen. Een onderzoek door McKinsey, Green Supply Chain: How Digitization Can Help You Reduce Your Carbon Footprint, geeft aan dat system-to-system oplossingen vastlopen op de geringste afwijking of vervuiling van invoerdata, zoals een doorgestreepte en met de hand gecorrigeerde gewichtsopgave op een douanedocument. Software mist de context om te bepalen welke waarde in een dergelijk scenario als de waarheid beschouwd moet worden.
De vertragende rol van ongestructureerde data
De structuurverwachtingen van een intern Enterprise Resource Planning (ERP) platform verschillen fundamenteel van de real-life aanlevering via een vrachtwagenchauffeur. ERP-systemen eisen de ontvangst van payload data in formaten als XML of JSON. De chauffeur overhandigt fysiek papier vol notities van magazijnmedewerkers, douanestempels in lege marges en onvolledige velden. Deze overgang van fysiek papier naar een digitaal inleesbare variant creëert een woud aan ongestructureerde data, waaronder scans die net niet recht op de flatbed liggen of e-mailbijlages in lage resoluties, waardoor automatische tekstherkenning de verwerking halverwege staakt.
Interpretatie van inconsistente meeteenheden
Geautomatiseerde calculaties falen frequent door louter en alleen variaties in transportmaten. Waar de ene vervoerder rapporteert in totale liters verbruikte diesel voor een ritverdeling, verstrekt de andere operator facturen uitgedrukt in tonkilometers of container Eenheden (TEU).
Zodra de brondata de meeteenheid onafhankelijk van een vooraf gedefinieerd formaat noteert (bijvoorbeeld '30 lbs' in plaats van '13.6 kg'), staken de berekeningsmodules. De variaties vereisen handmatige correcties, waardoor de beloofde stroomlijning via de API resulteert in gefragmenteerde, foutgevoelige data-sets in het basisregister.
Hybride verwerking vereist als fundament
Het elimineren van gaten in de emissieboeking vereist de consolidatie van ongestructureerde data met een hybride aanpak. De publicatie Guidance on Data Quality for GHG Emissions – Smart Freight Centre beschrijft de strikte kwaliteitseisen voor brondata bij emissierapportage; puur vertrouwen op rudimentaire datakwaliteit is een risico voor compliance en continuïteit.
De opbouw van betrouwbare systemen verloopt via een opeenvolgende werkwijze waarbij Robotic Process Automation (RPA) de volumineuze extractie begeleidt. Deze software "schraapt" de herkenbare informatie uit digitale platforms en standaard formulieren. Menselijke validatie, ook wel bekend als een hybride methode voor data-validatie, fungeert direct in het verlengde hiervan om contextuele fouten te identificeren en recht te trekken. Dit dichting van de kloof tussen uiteenlopende modale datasilo's creëert solide emissiedashboards die rusten op geverifieerde fundamenten.
Menselijke validatie als vangnet voor RPA
Uitzaaiingen van niet-standaard data forceren uitzonderingsrapporten (exceptions) in ieder geautomatiseerd extractiesysteem. Een douanedocument met complexe bijlagen of een afwijkende indelingscodering blokkeert de verdere RPA-loop. Menselijke context herkent de specifieke afwijking onmiddellijk op basis van operationele kennis over transportroutes. De controleur valideert de gegevens visueel en interpreteert de intentie van handmatige doorhalingen of stempels met afwijkende datums. Deze beoordelingsstap houdt de Data Accuracy intact zonder dat gehele processen stagneren bij afwijkingen.
Van gefragmenteerd logboek naar audit-ready data
Het einddoel is het structureren van een dataset die opgewassen is tegen rigoureuze inspecties onder de komende CSRD-audits. Het transformeren van ruwe en gefragmenteerde brondata naar een sluitend register draait puur om controle. Hybride validatie herstelt datalinks die door modaliteitswissels verbroken zijn. Hierdoor verdwijnen black boxes binnen de toeleveringsketens en kan de gehele rithistorie — van zeevracht in Sjanghai tot de aankomst bij een Europees distributiecentrum via de weg — exact gereproduceerd en verantwoord worden bij externe audits.
De structurele breukvlakken tussen scheepvaart, spoor en vrachtwagen illustreren hoe complex pure primary data verwerking in de praktijk is. Volledig geautomatiseerde systemen haperen bij inconsistenties op papier, waardoor bedrijven teruggrijpen op conservatieve schattingsoverzichten die het emissieprofiel scheeftrekken.
Voor inzicht en het voorbereiden op strakke emissieregelgeving is het valideren van modale data de directe volgende stap. DataMondial verenigt hoogopgeleide professionals met RPA-technologie binnen een strategische Nearshoring faciliteit in Roemenië; dit creëert een EU-compliant, schaalbaar hybride model. Verken hoe u orderverwerking en data-entry kunt uitbesteden en hoe de opbouw van audit-ready datasets met gegarandeerde kostenbeheersing uw logistieke rapportages versterkt.