Kundendaten für BI-Dashboards bereinigen: Wege aus der Datenfalle
Die Auswirkungen unvalidierter Quelldaten auf finanzielle Steuerungsinformationen
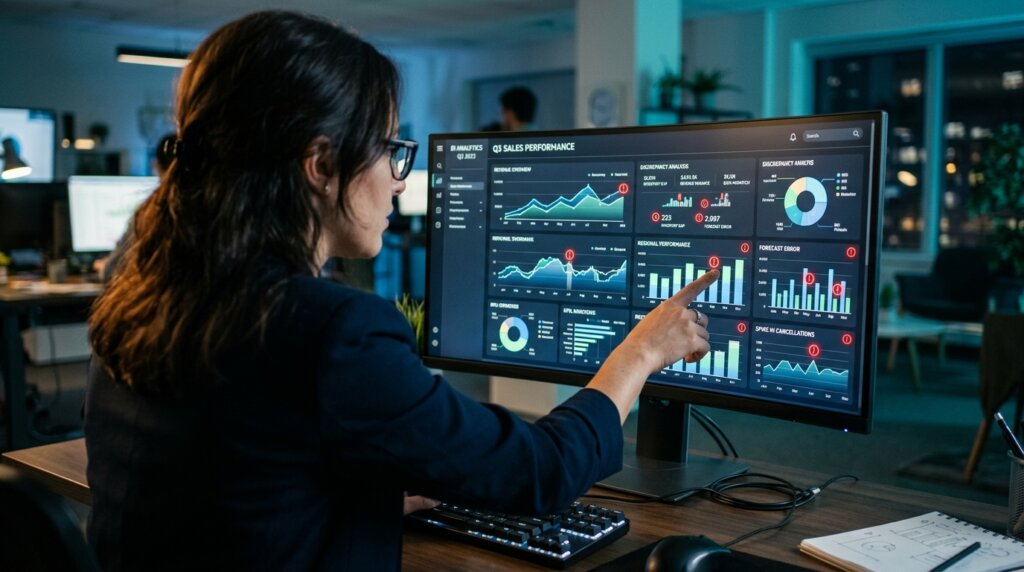
Diskrepanzen in BI-Dashboards sind selten das Ergebnis fehlerhafter Berechnungen oder einer falschen Query-Struktur; die Ursache liegt fast immer in den zugrunde liegenden Datensätzen der angebundenen CRM- und ERP-Systeme. Um dies zu beheben, müssen Sie Ihre Kundendaten bereinigen oder migrieren, da fehlerhafte Quelldaten die Umsatzanalysen unmittelbar verfälschen. Zwei doppelt angelegte Kundenprofile führen unweigerlich zu einer Überschätzung des Kundenstamms und einer Unterschätzung des Customer Lifetime Value (CLV). Auf operativer Ebene führt diese Datenverschmutzung zu direkt messbaren Schadensposten und Fehlerkosten. Datensätze, die über Jahre hinweg ohne aktive Validierung gewachsen sind, weisen häufig veraltete Adressdaten, fehlende Entitätsmerkmale und Doppelerfassungen auf. Dies mindert massiv die Zuverlässigkeit der Managementinformationen, auf deren Basis geschäftskritische Entscheidungen getroffen werden.
Versteckte Kosten in der Supply Chain und Administration
Fehlerhafte Daten übertragen sich eins zu eins in unnötige Ausgaben in der Supply Chain und binden administrative Ressourcen für nachträgliche Korrekturen. Verlässt eine Bestellung das Distributionszentrum mit einer unvollständigen Lieferadresse, entstehen sofort Transportkosten für die gescheiterte Zustellung, die Retoure und die anschließende Neulieferung. Zu Rechnungsausfällen kommt es, wenn finanzielle Stammdaten – wie Umsatzsteuer-Identifikationsnummern oder zwingend erforderliche Bestellnummern (PO-Nummern) – fehlen. Dies führt zu einem verzögerten Cashflow, da Rechnungen vom System des Empfängers automatisch abgewiesen werden. Das Forderungsmanagement verbringt wertvolle Zeit mit der Recherche und manuellen Korrektur dieser Rechnungsdaten, anstatt sich auf die Risikominimierung oder die Bearbeitung neuer Aufträge zu konzentrieren.
Blinde Flecken in der strategischen Entscheidungsfindung
Unvalidierte Daten verursachen Messfehler bei der Risikobewertung innerhalb der Reporting-Umgebung. Geschäftsführung und Managementteams steuern das Unternehmen anhand der präsentierten KPIs. Eine Fehleinschätzung der Kreditrisikostreuung entsteht beispielsweise dann, wenn eine Muttergesellschaft und die dazugehörigen Tochterunternehmen als separate, voneinander unabhängige Entitäten im System registriert sind. Das Dashboard zeigt in diesem Fall ein diversifiziertes Risikoprofil an, während sich das tatsächliche finanzielle Risiko bei einer einzigen Holding konzentriert. Strategische Entscheidungen über Marktexpansionen oder Produktentwicklungen, die auf solch verunreinigten Steuerungsinformationen basieren, führen fast unweigerlich zu einer ineffizienten Kapitalallokation.
Lösung 1: Vollautomatisierte Data-Cleansing-Software
Softwaregestützte Deduplizierung und Robotic Process Automation (RPA) bieten eine schnelle Methode zur Datenbereinigung – vorausgesetzt, die Quelle ist perfekt strukturiert. Automatisierungstools durchsuchen Datenbanken auf Basis vordefinierter Regeln. Sie vergleichen spezifische Datenfelder wie Firmenname, E-Mail-Adresse und Handelsregisternummer, um überschneidende Profile zu identifizieren und zusammenzuführen. Diese Tools laufen autonom im Hintergrund und können Tausende von Zeilen pro Stunde verarbeiten.
Effektivität bei einheitlichen Datensätzen
Bei standardisiertem Input liefert die softwaregestützte Bereinigung optimale Ergebnisse. Datensätze mit fest definierten Formaten, wie IBAN-Nummern oder länderspezifische Postleitzahlensysteme, lassen sich maschinell hervorragend überprüfen. Algorithmen erkennen Abweichungen in diesen festen Strukturen und korrigieren sie sofort. Die Verarbeitungsgeschwindigkeit ist immens, wodurch große Datenrückstände in kürzester Zeit auf die gewünschten Formate normalisiert werden.
Das Risiko von False Positives und aggressiver Deduplizierung
Algorithmen scheitern jedoch bei der Interpretation von Freitextfeldern und unstrukturierten logistischen Quelldaten. Frachtbriefe, Zolldokumente und abweichende Rechnungslayouts enthalten Daten ohne feste Struktur oder vorhersehbare Formatierung. Ein reiner Software-Ansatz generiert hier unweigerlich „False Positives“. Das System fasst beispielsweise zwei Logistikstandorte desselben Auftraggebers zu einem Profil zusammen, obwohl es sich in der Realität um ein physisch getrenntes Lager und den Hauptsitz handelt. Eine zu aggressive Deduplizierung führt somit zu einem dauerhaften Verlust zwingend notwendiger Nuancen und operativer Details im System.
Lösung 2: Interne manuelle Korrektur durch eigene Mitarbeiter
Die Zuweisung der Datenbereinigung an das bestehende Backoffice-Personal bietet zwar direkte Kontrolle über die Daten, beansprucht jedoch enorme operative Kapazitäten. Unternehmen können verschiedene Methoden der CRM-Datenmigration vergleichen, um zu bewerten, ob ein interner Ansatz der logischste Weg ist. Organisationen wählen diesen Weg oft, um die volle Entscheidungsgewalt zu behalten und zu vermeiden, dass Systeme von extern zugänglich gemacht werden müssen.
Kontextwissen als Qualitätssicherung
Der primäre Vorteil einer internen Bereinigungsrunde liegt in der direkten Anwendung spezifischen Prozesswissens. Mitarbeiter erkennen kundenspezifische Ausnahmen und historische Absprachen, die nicht immer zwingend in der Datenbank erfasst sind. Sie wissen zum Beispiel, dass die Dokumentation für einen bestimmten Kunden immer an eine abweichende Postadresse oder ein digitales Portal gesendet werden muss – unabhängig davon, was die Standard-Unternehmensdaten vorgeben. Diese menschliche Validierung garantiert ein hohes Maß an Data Accuracy auf Mikroebene, da der Kontext oder die spezifische Kundenbeziehung in die Datenverarbeitung einfließt.
Kapazitätsdruck und versteckte Lohnkosten
Bei großen Datenrückständen oder strukturellen Bereinigungszyklen wird die manuelle interne Korrektur betriebswirtschaftlich unhaltbar. Das Validieren fehlender Felder, das Zusammenführen von Duplikaten und das Digitalisieren von Papierdokumenten ist äußerst zeitintensiv. Wenn Account Manager oder Supply Chain Planner diese Aufgaben übernehmen, stagniert ihre eigentliche Kernarbeit. Dies führt unweigerlich zu Rückständen im operativen Tagesgeschäft. Die Lohnkosten in Westeuropa machen die manuelle Bereinigung von zehntausenden Datensätzen nach dieser Methode zu einer kostspieligen Übung mit einem sehr niedrigen Return on Investment (ROI).
Lösung 3: Hybrides Data-Cleansing (Tech & Mensch)
Eine skalierbare Alternative kombiniert die Rechenleistung von Algorithmen mit menschlicher Qualitätskontrolle im Rahmen eines Business Process Outsourcing (BPO)-Modells. Dieses Modell nutzt die Stärken beider Welten. BPO-Spezialisten an Nearshoring-Standorten bieten die Kapazität, dies in großem Maßstab durchzuführen – und das unter strikter Einhaltung von EU-Compliance und Datenschutzvorgaben.
RPA für Volumen, Data Stewards für Komplexität
Die Arbeitslast wird logisch aufgeteilt: Die Software normalisiert die Basisdaten, während der Mensch die Ausnahmen bewertet. Automatisierte Prozesse übernehmen die anfängliche Massenverarbeitung. Sie standardisieren Namensgebungen, entfernen exakte Duplikate und melden fehlende Pflichtwerte. Sobald die Software auf einen komplexen Datensatz stößt – wie eine unklare Beziehung zwischen zwei Entitäten oder handschriftliche Notizen auf einem Lieferbeleg – pausiert die Automatisierung für diese spezifische Zeile. Diese unstrukturierten Fälle werden an spezialisierte Data Stewards weitergeleitet. Über einen „Human-in-the-Loop“-Ansatz validieren sie diese Edge Cases manuell auf Basis des jeweiligen Kontextes.
Rahmenbedingungen für einen erfolgreichen hybriden Prozess
Ohne strenge operative Rahmenbedingungen stagniert die Verarbeitung auch in einem hybriden Modell. Der Prozess erfordert klare Business Rules, die genau definieren, wie Software und Mitarbeiter agieren müssen. Es muss im Vorfeld festgelegt werden, welches Quellsystem bei einem Merge-Konflikt führend ist und unter welchen Bedingungen ein menschlicher Steward eingreifen muss. Strikte Verarbeitungsprotokolle verhindern, dass Data Stewards Ad-hoc-Entscheidungen über Entitäten treffen. Die Sicherung dieser Datenqualität erfordert zudem systematische Stichproben und Audits während der Prozessausführung.
Entscheidungsmatrix: Welcher Ansatz passt zu Ihrer operativen Skalierung?
Die Wahl zwischen reiner Software, interner Bereinigung oder einem hybriden BPO-Modell hängt stark vom Datenvolumen und der Komplexität der Quelldateien ab. Bei geringen Volumina und einem hohen Bedarf an unternehmensspezifischem Kontext reicht ein internes Team völlig aus. Sobald die Volumina steigen, die Daten aber strikt einheitlich bleiben, bietet spezifische Bereinigungssoftware die Lösung. Bei großen, unstrukturierten Datensätzen – wie sie in der internationalen Logistik, bei Krankenversicherern oder in komplexen E-Commerce-Katalogen üblich sind – stellt ein hybrider Ansatz mittels Nearshoring aus Gründen der Skalierbarkeit den rentabelsten Weg dar.
Vergleich der Data-Cleansing-Methoden
Die nachstehende Matrix bewertet die drei Ansätze anhand der primären operativen Säulen.
| Methode | Geschwindigkeit | Kosten (pro Datensatz) | Genauigkeit bei unstrukturierten Daten | Auswirkungen auf eigene Kapazitäten |
|---|---|---|---|---|
| Vollautomatisiert | Hoch | Niedrig | Niedrig | Niedrig |
| Interne Mitarbeiter | Niedrig | Hoch | Hoch | Hoch |
| Hybrid (BPO / Tech & Mensch) | Hoch | Mittel | Hoch | Niedrig |
Checkliste: Vorbereitung Ihrer ERP-Daten
Bevor Sie einen Bereinigungsprozess anstoßen, sollten Sie den aktuellen Zustand Ihrer Quelldaten durch die folgenden Vorbereitungsschritte strukturiert erfassen:
- Quellen inventarisieren: Bestimmen Sie exakt, welche CRM-, ERP- oder TMS-Systeme das BI-Dashboard speisen.
- Den „Golden Record“ definieren: Legen Sie fest, welches System bei Datenkonflikten zwischen zwei Systemen die führende Instanz ist.
- Kritische Felder identifizieren: Markieren Sie, welche spezifischen Felder (wie USt-IdNr., IBAN oder Holdingstruktur) für korrekte finanzielle Steuerungsinformationen zwingend fehlerfrei sein müssen.
- Unstrukturierte Daten isolieren: Ziehen Sie eine strikte Trennlinie zwischen Feldern mit festen Formaten und Freitextfeldern oder verknüpften Anhangsdokumenten.
- Business Rules dokumentieren: Halten Sie in einer Arbeitsanweisung fest, wie bei Doppelregistrierungen oder sich teilweise überschneidenden Kundenprofilen zu verfahren ist.
Unzuverlässige Steuerungsinformationen in BI-Dashboards erfordern eine strukturelle Herangehensweise an die zugrunde liegenden Quelldaten. Während sowohl automatisierte Software als auch interne Mitarbeiter spezifische operative Grenzen aufweisen, bietet ein hybrider Datenbereinigungsprozess die perfekte Balance zwischen Skalierbarkeit und Genauigkeit. Durch die Kombination von Technologie mit menschlicher Validierung bleiben die Kosten kontrollierbar und operative Risiken werden nachhaltig neutralisiert. DataMondial ist ein niederländisches Unternehmen mit eigenen Nearshoring-Fazilitäten in Rumänien und lädt Sie ein, gemeinsam die Möglichkeiten zu evaluieren, um Ihre veralteten Datenbanken zu optimieren und ein vollständig EU-konformes Datenmanagement für Ihre Organisation zu implementieren.