Die ‚Äpfel-und-Birnen-Falle‘: Wie fehlerhaftes SKU-Matching Ihre E-Commerce-Margen vernichtet
Die Auswirkungen asymmetrischer Produktdaten auf die Margensicherung
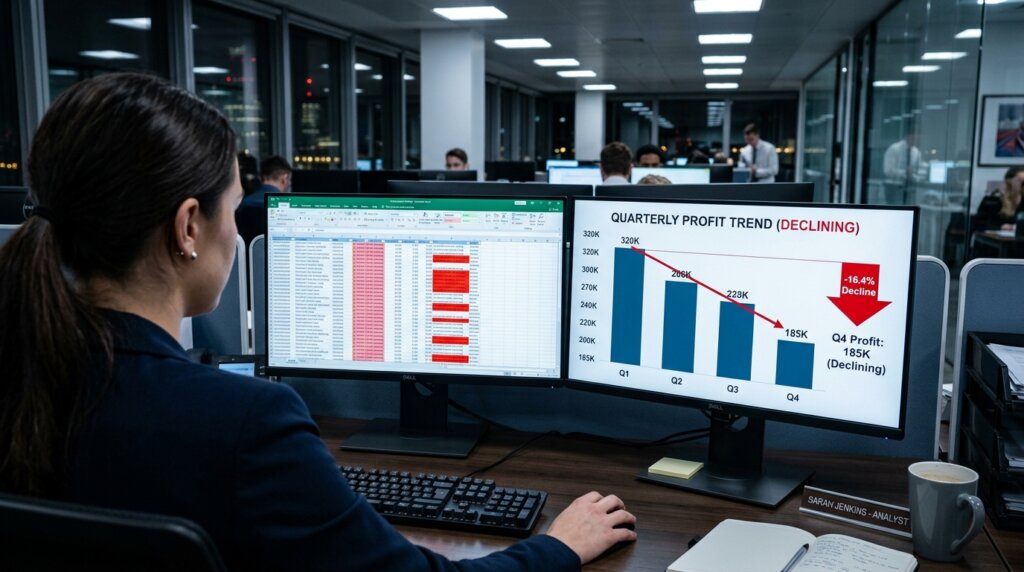
Fehlerhafte Produktdaten belasten die Gewinn- und Verlustrechnung (GuV) eines E-Commerce-Unternehmens unmittelbar. Wenn Systeme auf der Grundlage unstrukturierter oder asymmetrischer Daten zu einer blinden Preisautomatisierung übergehen, entstehen Abweichungen, die Algorithmen nicht eigenständig korrigieren können. Um dies zu verhindern, ist ein robuster Ansatz für Web-Recherche und Content-Management essenziell, um Ihre Wettbewerbsposition zu sichern. Dieses Problem konzentriert sich vor allem auf den aktiven Wiederverkauf etablierter Marken, bei dem die Kataloge verschiedener Anbieter miteinander konkurrieren. In Märkten, die ausschließlich mit einzigartigen, proprietären Single-SKU-Produkten operieren, besteht dieses Risiko nicht, da keine externen Vergleichsdaten existieren.
Der finanzielle Schaden automatisierter Fehler lässt sich präzise quantifizieren. Angenommen, ein Algorithmus ist darauf programmiert, immer den niedrigsten Marktpreis zu matchen. Verkäufer A bietet ein Produkt als 3er-Pack an. Verkäufer B bietet exakt dasselbe Produkt als 1er-Pack für ein Drittel des Preises an. Der Algorithmus von Verkäufer A erkennt über eine teilweise SKU-Übereinstimmung oder einen allgemeinen Produkttitel den Preis von Verkäufer B und stuft diesen als direkten Konkurrenten ein.
Daraufhin senkt das System den Verkaufspreis des 3er-Packs auf den Preis des 1er-Packs. Da dem Algorithmus der logische Kontext von Verpackungsabweichungen fehlt, sobald spezifische Parameter nicht exakt übereinstimmen, bleibt dieser reduzierte Preis aktiv. Wenn diese Situation in einer volumenstarken Kategorie sieben Tage lang unbemerkt bleibt, liefert der Verkäufer die Produkte mit Verlust an die Verbraucher aus, was direkt zulasten des Nettogewinns geht.
Ungerechtfertigte Preisrückgänge ohne Volumenzuwachs
Die Publikation Limitations of AI Product Matching in E-Commerce konstatiert, dass derartige Matching-Fehler das Fundament profitabler Preisstrategien vollends untergraben. In dem Rechenbeispiel des 3er-Packs, das zum Preis eines 1er-Packs verkauft wird, verbucht der Verkäufer unmittelbar die Einkaufskosten von zwei Einheiten als Totalverlust pro Transaktion – zuzüglich der angefallenen Versandkosten.
Dieser Verlust wird durch das Ausbleiben eines Volumenzuwachses, der einen Margenrückgang normalerweise kompensieren würde, noch verstärkt. Verbraucher kaufen in diesem Szenario keine größeren Mengen; sie profitieren schlichtweg von einem Systemfehler. Der Nettogewinn schrumpft, ohne dass dem ein strategischer Marktanteil gegenübersteht. Die Publikation Product Data Matching for E-commerce: AI Solutions 2026 bestätigt, dass blinde Vergleichstools ohne strukturierte Datenschicht zu einem negativen ROI bei automatisierten Repricing-Kampagnen führen.
Verborgene Bestände durch scheinbare Out-of-Stock-Fehler
Am anderen Ende des Spektrums führen asymmetrische Daten zu ungerechtfertigten Fehlmengenangaben. Physische Waren liegen versandbereit im Lager, sind aber digital unverkäuflich.
Dies geschieht, wenn Einkaufssysteme und Vertriebskanäle nicht dieselben Matching-IDs verwenden. Ein Produkt erhält bei der Einlagerung im Warehouse Management System (WMS) einen internen Code, der durch fehlerhaftes Mapping nicht mit der aktiven SKU im Frontend des Onlineshops übereinstimmt. Dies ist häufig der Bottleneck im Wareneingang, an dem Anschauungswirklichkeit und digitale Realität voneinander abweichen. Das Resultat: Der Lagerbestand bleibt auf null. Die Analyse im Bericht Inventory Discrepancies & SKU Mismatches: Causes, Fixes and Prevention zeigt auf, dass das Fehlen harter Verknüpfungen zwischen Backoffice-Daten und E-Commerce-Plattformen dazu führt, dass Betriebskapital unnötig in Lagern gebunden bleibt, während die Systeme fälschlicherweise neue Bestellungen generieren.
Drei Katalysatoren für SKU-Matching-Probleme in Artikelstämmen
Datenqualität bricht an ganz bestimmten, kritischen operativen Punkten innerhalb der Supply Chain ein. Beschaffungsprozesse und manuelle Dateneingaben sind die primären Phasen, in denen Asymmetrie entsteht. Ein sauberer Katalog setzt voraus, dass der anfängliche Input fehlerfrei ist. Sobald verunreinigte Daten in das E-Commerce-Ökosystem gelangen, breiten sich die Fehler unweigerlich auf Repricing-Tools, Bestandssysteme und finanzielle Dashboards aus.
Verpackungs-Updates und EAN-Recycling durch Lieferanten
Ein bekannter Pain Point im Katalogmanagement hat seinen Ursprung oft direkt beim Hersteller. Gemäß den in den GS1 Barcode Fundamentals beschriebenen Richtlinien muss jede noch so kleine Änderung an einem Produkt zu einer neuen EAN-Nummer (European Article Number) führen. In der Praxis recyceln Lieferanten jedoch regelmäßig bestehende Barcodes für aktualisierte Verpackungen oder leicht modifizierte Versionen, wie zum Beispiel Produkte mit geänderten Inhaltsstoffen.
Wenn eine alte EAN an einem neuen Produkt haften bleibt, stört dies die E-Commerce-Systeme erheblich. Ein Preisvergleichsportal sucht nach der EAN und verknüpft die historischen Preisdaten der alten Version, die möglicherweise von Konkurrenten als Rabattartikel abverkauft wird, mit der aktualisierten Version, die mit voller Marge verkauft werden sollte. Wie in Fuzzy Matching Algorithms for SKU Alignment detailliert dargelegt wird, verlieren Algorithmen ihre Orientierung, wenn der primäre Referenzpunkt – der eindeutige Identifikator – seine Eindeutigkeit verliert.
Fehlende Normalisierung von Produkteinheiten
Cross-Border-E-Commerce zwingt Systeme unweigerlich dazu, mit internationalen Messunterschieden umzugehen. Wenn ein Onlineshop Produkte aus den Vereinigten Staaten importiert und in Europa vertreibt, fluktuieren die Einheiten zwischen dem imperialen und dem metrischen System. Flaschen von 16 Fluid Ounces müssen mit Halbliterflaschen verglichen werden.
Passieren eingehende Feeds keine Normalisierungsschicht, die Gewichte und Volumina auf eine einheitliche Basis standardisiert, entsteht Datenrauschen. Konvertierungsfehler führen dazu, dass ein Algorithmus eine 500-Milliliter-Verpackung als völlig anderes Produkt behandelt als exakt dieselbe Flüssigkeit mit der Angabe 16,9 Unzen. Core Architecture: Catalog Matching Fundamentals for Price Intelligence zeigt, dass das Fehlen einer automatisierten Einheitenkonvertierung zu unvollständigen Preisvergleichen führt, da konkurrierende Angebote systematisch übersehen werden.
Erzwungenes Clustering generischer Produktvarianten
Sammel-SKUs stellen ein operationelles Risiko dar. Mitunter entscheiden sich Datenverantwortliche dafür, verschiedene Farbnuancen oder leichte Modelländerungen unter einer Haupt-SKU zusammenzufassen, um den Katalog optisch übersichtlich zu halten. Dies beraubt spezifische Produktvarianten jedoch ihrer digitalen Identität.
In automatisierten Daten-Feeds ist ein spezifisches Modell zwingend erforderlich, um den Bestand und Preis pro Stück granular zu verwalten. Wählt ein Konsument eine generische Option „verschiedene Farben“ ohne spezifische Varianten-SKU, scheitert das Bestandssystem bei der Bestandsabbuchung. Um diesen Ursachen präventiv entgegenzuwirken, implementieren kompetente operative Teams ein striktes Controlling für die folgenden drei Datenpunkte:
- Verpackungstyp (Anzahl der Konsumenteneinheiten pro Versandeinheit)
- Produkteinheit (Standardisierte metrische Eingabe)
- Veröffentlichungsjahr (Identifikation stiller Updates unter derselben EAN)
Der blinde Fleck automatisierter Preis-Monitore
Sich ausschließlich auf technologische Preis-Monitore zu verlassen, schafft enorme Schwachstellen. Reine KI-Lösungen und Scraper implementieren Regeln zwar schneller als ein Mensch, ihnen fehlt jedoch die analytische Fähigkeit bei Mehrdeutigkeit (Ambiguität). Wenn an der Quelle ein Datenproblem auftritt, skaliert die Automatisierung diesen Fehler ungehindert durch die gesamte operative Struktur.
Für Sortimente unter 100 Produkten rechnet sich die Investition in umfangreiche Web-Recherche und manuelle Validierung nur selten. Hier ist eine rein händische Kontrolle direkt umsetzbar. Bei tausenden von SKUs hingegen, so Core Architecture: Catalog Matching Fundamentals for Price Intelligence, versagen automatisierte Systeme ohne einen strukturierten, hybriden Prozess zwangsläufig – einen Prozess, in dem Technologie und menschliche Urteilskraft nahtlos zusammenarbeiten.
Text- versus Bildinterpretation beim Scraping
Standard-Scraping-Tools basieren auf String-Vergleichen (Zeichenkettenvergleich). Sie scannen das Internet, lesen Texte und gleichen Titel sowie Beschreibungen ab. Die technische Limitierung liegt hierbei in der Unfähigkeit, visuelle Produktunterschiede in Bildern präzise und zutreffend zu interpretieren.
Dynamische Produkttitel bei konkurrierenden Verkäufern täuschen die starren Regeln des Codes. Ein Wettbewerber kann online ein Angebot mit dem Titel ‚Produkt X – 50ML‘ schalten, während das beigefügte Foto eine Aktionsverpackung mit zwei Flaschen zeigt. Der Algorithmus liest den Text, übersieht die fehlende Multipack-Erwähnung und kreiert fehlerhafte Preis-Matches, sogenannte ‚Phantom Comparisons‘. Der Bericht Limitations of AI Product Matching in E-Commerce beschreibt eindrücklich, wie der Ausschluss des visuellen Bildkontexts in Scrapern die Zuverlässigkeit der generierten Daten drastisch senkt.
Die Notwendigkeit einer hybriden Validierungsschicht
Ein stabiles Fundament für Price Intelligence erfordert professionelle Web-Recherche. Algorithmen identifizieren potenzielle Matches, markieren Preisabweichungen bei margenstarken Artikeln und signalisieren unbekannte EAN-Codes. Anstatt diese Daten unkontrolliert in Aktionen im E-Commerce-Frontend zu übersetzen, fungieren sie als Input für eine menschliche Validierungsschicht.
Geschulte Daten-Spezialisten auf Expertenniveau beurteilen die markierten Elemente, korrigieren falsch interpretierte Verpackungseinheiten und selektieren alte Produktversionen exakt von Neuerscheinungen. Diese tiefgehende Bereinigung minimiert die Fehlertoleranz in großflächigen Katalogen und garantiert, dass die finalen Daten, die das WMS und die E-Commerce-Plattformen speisen, faktisch wasserdicht sind.
Fehlerhaftes SKU-Matching ist nicht nur ein technisches Ärgernis, sondern eine quantifizierbare Ursache für Margenverluste und Kapitalvernichtung im E-Commerce. Durch EAN-Recycling und unzureichende Normalisierung scheitern Algorithmen bei der Ermittlung korrekter Preise und Bestände, was unweigerlich zu Preisdumping und der Blockade verkaufsfähiger Waren führt. Die Implementierung einer hybriden Validierungsschicht stoppt diese Abwärtsspirale, indem sie automatisierte Erkennung mit scharfem, menschlichem Verstand (Human-in-the-Loop) kombiniert. Für eine erfolgreiche Strategie sollten Sie sich dafür entscheiden, Preise und Wettbewerbsdaten strukturiert zu überwachen, um den Fokus auf Ihre Marktposition zu behalten.
Für Organisationen mit komplexen Datenströmen bietet DataMondial skalierbare Lösungen durch hochwertige BPO-Dienstleistungen an. Aus unseren EU-konformen Nearshoring-Einrichtungen in Rumänien übernimmt ein Team von Spezialisten die groß angelegte Bereinigung, Web-Recherche und Strukturierung von E-Commerce-Katalogen im Bereich des Daten- und Content-Managements. Steigern Sie Ihre Data Accuracy, senken Sie interne Betriebskosten und implementieren Sie einen fehlerfreien hybriden Prozess für nachhaltige Stabilität. Kontaktieren Sie DataMondial, um die aktuellen Asymmetrien in Ihren Produktdaten kompetent analysieren zu lassen.