Das multimodale Messproblem: Wie Emissionsdaten an der Schnittstelle von Schiff, Zug und Lkw verloren gehen
Wo die Kette reißt: Vom Terminal ins Hinterland
Beim intermodalen Transport kommt es strukturell genau in dem Moment zu Datenverlusten, in dem ein Container den Verkehrsträger (die Modalität) wechselt. Während der physische Umschlag reibungslos verläuft, folgt der Datenstrom einem stark fragmentierten Pfad. Innerhalb der Logistikkette überschreiten Güter die Grenzen geschlossener digitaler Ökosysteme, wodurch primäre Emissionsdaten an den Schaltern der Terminals stagnieren. Ein professioneller Partner für die präzise Datenverarbeitung unterstützt Unternehmen dabei, diese verlorenen Informationen wieder zentral und nutzbar zur Verfügung zu stellen.
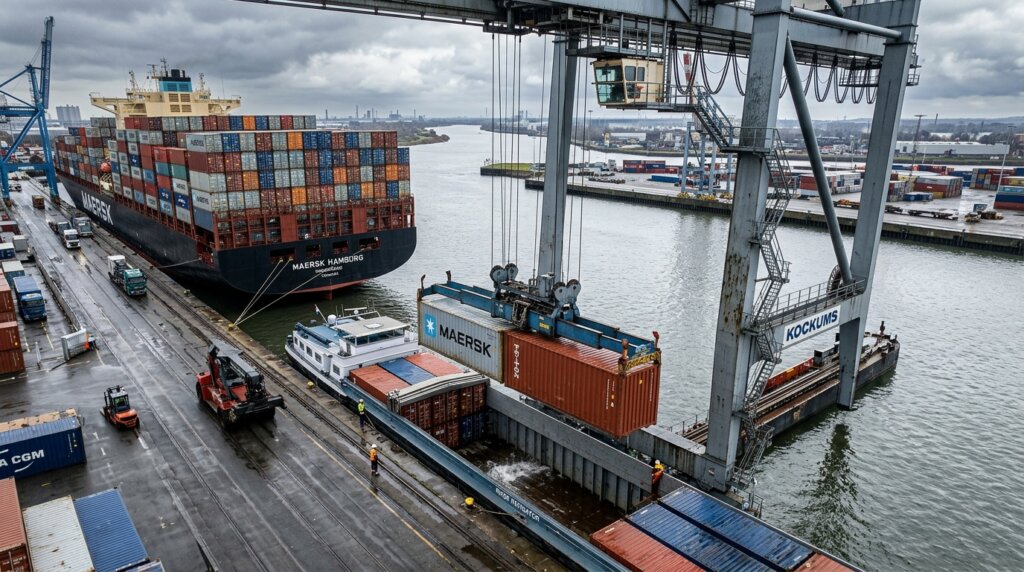
Die Dokumentation in der Seefracht ist streng organisiert. Reedereien und große Terminals kommunizieren über standardisierte EDI-Protokolle, die präzise Ladungsdaten, Gewichte und Entfernungen übermitteln. Doch in dem Moment, in dem der Container das Terminal oder Binnenschiff über den Hafenkran für den Nachlauf verlässt, endet diese digitale Eindeutigkeit. Die Systeme lokaler Straßen- und Schienentransporteure arbeiten mit unterschiedlichsten Formaten – von Webportalen über unstrukturierte PDF-Dateien bis hin zum physischen CMR-Frachtbrief in Papierform. Im Bericht CO2 Emissions Reporting: Challenges and Opportunities for the Logistics Industry wird genau dieser Übergang als Hauptursache für Datenlücken im End-to-End Carbon Tracking identifiziert.
Die manuelle Dokumentenübergabe und die analoge Abfertigung an den Schaltern führen zu unmittelbaren Verzögerungen bei der Erfassung von Quelldaten. Transportplaner müssen oft warten, bis die Fahrer am Ende der Arbeitswoche ihre gedruckten Frachtbriefe einreichen, was eine Echtzeit-Emissionsberechnung schlichtweg blockiert.
| Verkehrsträger (Modalität) | Typischer Datenstandard | Primärer Datenträger | Auswirkungen auf das Emissions-Tracking |
|---|---|---|---|
| Seefracht | EDI oder API (standardisiert) | Digital | Hoch: Präzise Integration möglich |
| Binnenschifffahrt / Schiene | Divers: XML, Webportale, PDF | Digital / Print | Mittel: Oft Konvertierung für das TMS erforderlich |
| Straßenverkehr (lokal) | Eigenes TMS-Format oder kein Standard | Papier oder eCMR / PDF | Gering: Manuelle Eingabe durchbricht Primärdatenstrom |
Der Konflikt zwischen Systemdaten und operativer Dokumentation beim Terminalumschlag
Die Kluft zwischen strukturieren EDI-Nachrichten und unstrukturierten lokalen Frachtbriefen reißt irreparable Lücken in die Transportdossiers. EDI erfordert ein striktes Field Mapping, bei dem jeder Datenpunkt – vom Bruttogewicht bis hin zur Referenznummer – exakt übereinstimmen muss. Sobald der physische Nachlauf beginnt, erstellt der lokale Spediteur Dokumente auf Basis eigener Vorschriften und Prozesse. Die Initiative Digitalisation and Electronic Freight Transport Information (eFTI) beschreibt detailliert, wie unterschiedliche Auslegungen von Dokumentationspflichten die Transparenz in der Lieferkette stören. Ein digitales Frontend-System erwartet eine nahtlose Datenübermittlung, erhält in der Praxis jedoch lediglich Kopien von Zolldokumenten und unvollständig ausgefüllte Frachtbriefe.
Der Verlust der Sendungsnummer
Sobald ein Seecontainer auf einen Lkw umgeschlagen wird, legt der Spediteur in seinem eigenen Transport Management System (TMS) eine neue Fahrt an. Die technische Logik dieser Systeme erzwingt oft die Generierung einer neuen, systemeigenen Transport- oder Referenznummer. Dadurch wird die ursprüngliche, übergreifende Sendungsnummer überschrieben oder schlichtweg ignoriert. Der Emissionsfaktor der spezifischen Ladung wird so unwiderruflich von den historischen Frachtdaten entkoppelt. Gemäß den Richtlinien zur Electronic Consignment Note (eCMR) – UNECE bietet die Digitalisierung des Frachtbriefs enormes Potenzial. Das Fehlen einer flächendeckenden Akzeptanz führt jedoch dazu, dass Referenznummern weiterhin manuell übertragen werden müssen – ein Arbeitsschritt, der im operativen Stress oft ausfällt oder Tippfehler verursacht.
Die Auswirkungen fragmentierter Datenquellen auf Scope 3
Die direkte Quantifizierung operativer Risiken beginnt bei der Analyse dieser Datenverluste auf Reporting-Ebene. Wenn primäre Quelldaten fehlen oder durch Formatänderungen unlesbar werden, zwingen anerkannte Berichtsstandards wie das GLEC Framework 2.0 Unternehmen dazu, auf Branchendurchschnitte (Default Values) zurückzugreifen. Ohne überprüfbare logistische Bewegungsdaten auf Sendungsebene – wie den tatsächlichen Kraftstoffverbrauch oder das exakte Ladegewicht – rechnet die Methodik mit konservativen Schätzwerten, um ein Under-Reporting (Untererfassung) zu vermeiden.
Dies führt in der Konsequenz zu einem künstlich verschlechterten CO2-Profil. Unternehmen, die der Corporate Sustainability Reporting Directive (CSRD) unterliegen, werden an der Genauigkeit dieser Emissionszahlen gemessen. Das Dokument Frequently Asked Questions: Corporate Sustainability Reporting Directive (CSRD) stellt klar, dass Wirtschaftsprüfer sehr genau auf die Verwendung gemessener Primärdaten für Scope-3-Emissionen im Gegensatz zu bloßen Näherungswerten achten. Die fehlende Systemverknüpfung zwingt Backoffice-Mitarbeiter zu zeitaufwendigen Recherchen: Routen müssen im Nachhinein anhand loser Rechnungen, Wiegerechnungen und E-Mail-Verläufe mühsam rekonstruiert werden, um doch noch eine präzisere Berechnung einreichen zu können.
Rechenbeispiel: Datenverlust auf der Route Rotterdam – Duisburg
Die Folgen einer fehlerhaften Datenübertragung spiegeln sich direkt in ungenauen CO2-Fußabdrücken wider. Die Technical Guidance for Calculating Scope 3 Emissions – GHG Protocol sowie die Studie STREAM – Studie naar TRansport Emissies van Alle Modaliteiten (Update) bilden die Grundlage für Emissionsberechnungen, bei denen die modale Unterscheidung das Endergebnis bestimmt. Das folgende Fallbeispiel veranschaulicht den negativen Effekt von Datenverlusten:
- Ankunft Deepsea-Terminal Rotterdam: Die Sendung wird unter dem Master Bill of Lading X123 registriert. EDI-Nachrichten berechnen die maritimen Emissionen basierend auf der Strecke Shanghai – Rotterdam auf die Nachkommastelle genau.
- Umschlag auf ein Binnenschiff: Die Ladung (Bruttogewicht 20.000 kg) reist per Binnenschiff (Barge) nach Duisburg. Der operative Emissionsfaktor für die Binnenschifffahrt ist, gerechnet auf Tonnenkilometer, sehr niedrig (~20 Gramm CO2e/tkm).
- Datenabbruch am Kai in Duisburg: Bei Ankunft wird das Binnenschiff entladen. Ein lokaler Transporteur holt den Container physisch mit einem Lkw ab, begleitet von einem handgeschriebenen CMR-Frachtbrief, auf dem die ursprüngliche Referenznummer X123 fehlt.
- Kalkulation mit fehlenden Parametern: Am Ende des Quartals konsolidiert der Verlader seine Daten. Da die digitale Verbindung zwischen Binnenschiff und Straßentransport gerissen ist, sieht das Emissionsberechnungssystem im Backoffice für diesen Logistikauftrag lediglich den Startpunkt (Rotterdam) und den Endpunkt (das Lager in Deutschland).
- Das Resultat — die konservative Strafe: Der Algorithmus wendet die Fallback-Methode an. Anstatt die hochgradig effiziente Binnenschifffahrt zu berücksichtigen, stuft das System die gesamte Route von Rotterdam bis zum Lager als reinen Straßentransport ein (beispielsweise als Heavy Duty Truck mit einem Emissionsfaktor von ~75 Gramm CO2e/tkm). Die ausgewiesenen Scope-3-Emissionen für diese Sendung fallen somit mehr als dreimal höher aus.
Die Anfälligkeit des Nachlaufs auf dem Spotmarkt
Die Stabilität der Daten variiert extrem, je nach gewählter Vertragsform. Feste, langfristige Logistikverträge (Dedicated Fleets) nutzen standardisierte Datenprotokolle. Bei solchen Partnerschaften erzwingt das Service Level Agreement die Interoperabilität zwischen dem ERP-System des Verladers und dem TMS des Frachtführers. Die Erfassung der Primärdaten wird so systematisch sichergestellt.
Die hohe Dynamik des Spotmarktes stört diesen Prozess jedoch massiv. Ad-hoc-Fahrten werden an eine stark zersplitterte Gruppe von Subunternehmern vergeben, die jeweils unterschiedliche oder in einigen Fällen gar keine TMS-Lösungen verwenden. Die Daten existieren hier fast ausschließlich auf isolierten Trägermedien, was es unmöglich macht, aktuelle Emissionsfaktoren ohne manuelle Eingriffe und aufwendige Aktenprüfungen abzurufen.
Warum API-Schnittstellen an Frachtdokumenten scheitern
Rein technologische Ansätze, wie isolierte API-Integrationen, bieten keine ausreichende Lösung für das intermodale Datenmanagement. In hochgradig standardisierten Umgebungen brillieren Software-Kopplungen, doch die enorme Heterogenität externer Logistikketten bringt solche Systeme häufig zum sofortigen Stillstand.
APIs sind dafür konzipiert, vordefinierte Datenströme asynchron zu verarbeiten. Die unstrukturierte Realität globaler Frachtdokumentation weigert sich schlichtweg, in diese standardisierten Schemata zu passen. Eine McKinsey-Studie, Green Supply Chain: How Digitization Can Help You Reduce Your Carbon Footprint, zeigt deutlich, dass System-to-System-Lösungen bereits bei der geringsten Abweichung oder Verunreinigung der Eingabedaten scheitern – etwa bei einer durchgestrichenen und handschriftlich korrigierten Gewichtsangabe auf einem Zolldokument. Der Software fehlt der entscheidende Kontext, um zu beurteilen, welcher Wert in einem solchen Szenario als die tatsächliche Wahrheit betrachtet werden muss.
Die bremsende Wirkung unstrukturierter Daten
Die Strukturerwartungen einer internen ERP-Plattform (Enterprise Resource Planning) weichen fundamental von der realen Anlieferung durch einen Lkw-Fahrer ab. ERP-Systeme verlangen die Einspeisung von Payload-Daten in sauberen Formaten wie XML oder JSON. Der Fahrer hingegen überreicht meist physisches Papier, gespickt mit handschriftlichen Notizen von Lagermitarbeitern, mit Zollstempeln am Rand und unvollständig ausgefüllten Feldern. Dieser medienbruchbehaftete Übergang vom physischen Papier hin zu einer digital auslesbaren Variante erzeugt einen wahren Dschungel unstrukturierter Daten. Dazu zählen Scans, die nicht gerade auf dem Vorlagenglas lagen, oder E-Mail-Anhänge in niedriger Auflösung, wodurch die automatische Texterkennung die Verarbeitung auf halbem Weg abbricht.
Die Interpretation inkonsistenter Maßeinheiten
Automatisierte Berechnungen scheitern regelmäßig schon aufgrund simpelster Abweichungen bei den Transportkennzahlen. Wo der eine Spediteur den verbrauchten Diesel in Gesamtlitern für eine Fahrt abrechnet, stellt der nächste Operator seine Rechnungen ausgewiesen in Tonnenkilometern oder Container-Einheiten (TEU) aus.
Sobald die primären Quelldaten abweichend vom vordefinierten Format notiert sind (zum Beispiel ’30 lbs‘ statt ‚13,6 kg‘), streiken die reinen Berechnungsmodule. Solche Variablen erfordern zwingend manuelle Korrekturen, wodurch die vollmundig versprochene Effizienzsteigerung durch die API unweigerlich in hochgradig fragmentierten, fehleranfälligen Datensätzen im Basisregister mündet.
Hybride Datenverarbeitung als zwingendes Fundament
Um Datenlücken in der Emissionserfassung dauerhaft zu schließen, ist die intelligente Konsolidierung unstrukturierter Daten durch einen hybriden Ansatz elementar. Die Publikation Guidance on Data Quality for GHG Emissions – Smart Freight Centre beschreibt die unerbittlichen Qualitätsanforderungen an Quelldaten bei der Emissionsberichterstattung; rein auf fehlerhafte oder unvollständige Basisdaten zu vertrauen, ist ein massives Risiko für Compliance und Geschäftskontinuität.
Der Aufbau belastbarer Systeme erfordert einen mehrstufigen Ansatz, bei dem Robotic Process Automation (RPA) initial die volumenstarke Extraktion übernimmt. Diese Software „schürft“ die eindeutig erkennbaren Informationen rigoros aus digitalen Plattformen und Standardformularen. Die menschliche Validierung, im Fachjargon der Branche auch als hybride Methode zur Datenvalidierung bekannt, fungiert als direkte Erweiterung, um kontextuelle Fehler zu identifizieren und sofort zu berichtigen. Genau dieser Brückenschlag zwischen den isolierten, modalen Datensilos schafft verlässliche Emissions-Dashboards, die auf einem absolut sicheren Fundament ruhen.
Menschliche Validierung als Sicherheitsnetz für RPA
Stark abweichende, nicht-standardisierte Daten provozieren in jedem noch so hochgezüchteten Extraktionssystem unweigerlich Ausnahmen (Exceptions). Ein Zolldokument mit komplex verschachtelten Anlagen oder einer völlig abweichenden Formatierung (Layout-Änderung) bringt den RPA-Prozess umgehend zum Erliegen. Das komplexe, menschliche Wissen aus der Fachabteilung erkennt die spezifische Abweichung auf Basis operativer Erfahrung bei Transportrouten jedoch oft sofort. Der Sachbearbeiter validiert die Daten visuell und interpretiert problemlos die wahre Absicht hinter handschriftlichen Streichungen oder Stempeln mit abweichenden Daten. Dieser unersetzliche Prüfungsschritt hält die Data Accuracy konsequent hoch, ohne dass Gesamtprozesse bei den kleinsten Anomalien sofort zum Stillstand kommen.
Vom fragmentierten Logbuch zu audit-ready Daten
Das oberste strategische Ziel ist die Strukturierung eines soliden Datensatzes, der den strengen Inspektionen der kommenden CSRD-Audits souverän standhält. Die gezielte Transformation von rohen und unvollständigen Quelldaten in ein lückenloses, revisionssicheres Register ist primär eine Frage der Kontrolle. Eine hybride Validierung stellt genau jene Querverbindungen wieder her, die der Wechsel der Verkehrsträger zerrissen hat. Blackboxes innerhalb der globalen Lieferkette verschwinden so vollständig und der gesamte Lebenszyklus der Fracht – vom Seetransport in Shanghai bis zur Endanlieferung in einem europäischen Distributionszentrum per Lkw – kann gegenüber externen Sachverständigengruppen präzise reproduziert und vollumfänglich belegt werden.
Die strukturellen Bruchstellen an den Übergängen zwischen Schifffahrt, Schiene und Lkw verdeutlichen sehr genau, wie komplex eine rein automatisierte Primärdatenverarbeitung in der beruflichen Praxis wirklich ist. Ausnahmslos vollautomatisierte Systeme geraten durch banale Inkonsistenzen auf dem Papier sofort ins Straucheln, weshalb Betriebe wiederholt auf unsichere, sehr weite Schätzhorizonte ausweichen müssen, die das eigene CO2-Profil künstlich in die Höhe treiben.
Um unverfälschte Einblicke zu schaffen und sich bestmöglich auf immer härtere Emissionsvorschriften vorzubereiten, ist das zuverlässige Validieren der Übergangsdaten der einzig logische, direkte Folgeschritt. DataMondial vereint exzellent ausgebildete Fachkräfte intelligent mit moderner RPA-Technologie in einem strategischen Nearshoring-Center in Rumänien; so entsteht ein durch und durch EU-konformes, skalierbares Hybrid-Modell. Erkunden Sie jetzt, wie Sie die Auftragsabwicklung und Dateneingabe auslagern können und wie der belastbare Rückgriff auf auditsichere (audit-ready) Datensätze bei streng garantierter Kostenkontrolle Ihr Reporting in der Logistik nachhaltig absichert.