Warum Ihr Logistik-Dashboard Fehlalarme produziert (und wie Sie Supply Chain Alert Fatigue stoppen)
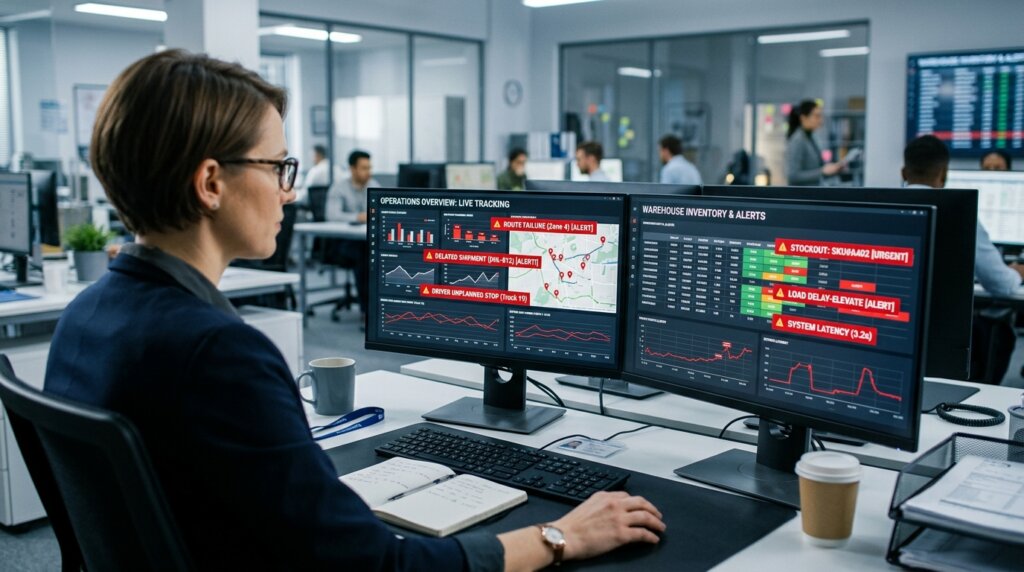
Fehlerhafte Dateneingaben sind die Hauptursache für unzuverlässige Dashboards. Entlang der Lieferkette fließen täglich Tausende von Datenpunkten in Systeme wie ein Transport Management System (TMS) oder einen Supply Chain Control Tower. Wenn Disponenten kontinuierlich Pop-ups und Warnmeldungen wegklicken müssen, brennt in der Lieferkette selten wirklich ein Feuer. Vielmehr offenbart dies eine Bruchstelle zwischen der manuellen Dateneingabe im Backoffice-Outsourcing für die Logistik und der Verarbeitung durch die nachgelagerten Systeme.
Die Ursache für dieses Systemrauschen liegt häufig in asynchronen Updates der Speditionssoftware. Modifiziert ein Spediteur beispielsweise das Abfahrtsdatum in einem lokalen System, erreicht diese Änderung das übergeordnete Dashboard aufgrund von Synchronisationsverzögerungen nicht rechtzeitig. Das System registriert eine Abweichung zwischen dem geplanten und dem tatsächlichen Status und generiert eine Warnung. Ein weiteres strukturelles Problem entsteht durch doppelt erfasste Zolldokumente. Wird ein Frachtdokument mit einer minimalen Abweichung in der Referenznummer zweimal eingegeben, initiiert das System zwei parallele Workflows. Sobald sich die physische Sendung bewegt, bleibt die „Geisterbuchung“ zurück – was zu hartnäckigen roten Flaggen für eine Sendung führt, die in Wahrheit längst zugestellt wurde.
Auch die verzögerte manuelle Übertragung von ETAs (Estimated Time of Arrival) aus PDF-Dateien oder E-Mails in das operative System provoziert falsche Signale. Während der Lkw physisch bereits vor dem Lager steht, meldet das System eine Verspätung, da die vorverlegte ETA nie verarbeitet wurde. Damit operative Teams keine wertvollen Stunden mehr mit der Jagd nach solchen Datenfehlern verschwenden, ist ein feingranulares diagnostisches Framework unerlässlich.
Die Anatomie einer falschen Supply-Chain-Warnung
Um administrative Rückstände von echten logistischen Engpässen zu trennen, müssen Planer sofort erkennen können, ob eine Warnung auf „Data Decay“ (Datenverfall) oder auf eine tatsächlich feststeckende Sendung zurückzuführen ist. Veraltete oder unvalidierte Daten triggern Algorithmen auf dieselbe Weise wie ein physischer Stopp bei einer Grenzkontrolle.
Checkliste: Administrativer Verzug oder echte physische Blockade?
Nutzen Sie die folgenden fünf Datenpunkte, um den Ursprung einer Benachrichtigung zu verifizieren, bevor Sie eine operative Eskalation einleiten:
- Scan-Zeitpunkt versus System-Update: Vergleichen Sie den Zeitstempel des letzten physischen Barcode-Scans mit dem Zeitpunkt, an dem der Datensatz im TMS aktualisiert wurde. Eine große Diskrepanz deutet auf einen Eingaberückstand hin.
- Deduplizierung von Zollreferenzen: Kontrollieren Sie, ob sich die MRN-Nummer (Master Reference Number) oder der Frachtbrief auf einen Dokumentationsfluss bezieht, der bereits unter einer anderen internen Aktennummer abgewickelt wurde. Dies verhindert die fehlerhafte Verarbeitung von Zolldokumenten innerhalb des Systems.
- API-Statuskontrolle: Verifizieren Sie, ob der Status in der Standalone-Speditionssoftware exakt mit dem Status im Control Tower übereinstimmt. Diskrepanzen weisen auf fehlerhafte asynchrone Schnittstellen hin.
- Protokoll der ETA-Änderungen: Prüfen Sie die Änderungshistorie des ETA-Feldes. Eine starre, unveränderte ETA bei einer Sendung, die bereits mehrere Transitpunkte passiert hat, ist ein starkes Indiz für vergessene manuelle Übertragungen.
- Externe Validierung an der Quelle: Überprüfen Sie den aktuellen Container- oder Trailerstatus direkt über das native Portal der Reederei oder des Frachtführers, um die lokalen Systemdaten mit der aktuellen Realität abzugleichen.
Die verborgenen Kosten operativer Systemblindheit
„Alert Fatigue“ geht in der Praxis direkt auf Kosten der FTE-Kapazitäten und schwächt das Risikomanagement strukturell. Disponenten, die täglich Hunderte von Systemwarnungen erhalten, entwickeln einen blinden Fleck für echte Anomalien. Die operative Realität zwingt diese Mitarbeiter dazu, primär „Geisterverspätungen“ hinterherzujagen: Warnungen über Sendungen, die physisch im Zeitplan liegen, aber administrativ im Rückstand sind.
Dieser immense Arbeitsdruck begünstigt unweigerlich eine „Mark-as-read“-Kultur. Mitarbeiter klicken reihenweise Warnmeldungen weg, nur um das Dashboard übersichtlich zu halten. Durch diese Routine bleiben kritische Eskalationen – wie beispielsweise ein Container, der bei einer Zollinspektion festsitzt – im Rauschen der administrativen Datenfehler unbemerkt. Die Fähigkeit der Organisation, bei echten Vorfällen proaktiv einzugreifen, schwindet zusehends.
Rechenbeispiel: Die harten Tageskosten von 50 Fehlalarmen
Um die Auswirkungen von Systemrauschen auf Ihr Budget und die tägliche Geschäftskontinuität greifbar zu machen, finden Sie hier eine konkrete Aufschlüsselung des Zeit- und Kostenaufwands für ein mittelgroßes Backoffice:
- Anzahl der Fehlalarme: 50 pro Tag und Niederlassung.
- Zeitaufwand für die Verifizierung: Mindestens 10 Minuten pro Warnung (Recherche in Quellsystemen, Telefonate mit Spediteuren, Abgleich von E-Mails).
- Täglicher Zeitaufwand: 500 Minuten (ca. 8,33 Stunden).
- Operative Auswirkungen: Etwas mehr als eine vollständige, hoch qualifizierte Vollzeitkraft (FTE) verbringt einen kompletten Arbeitstag damit, unnötige Warnungen zu klären, anstatt sich der Kapazitätsplanung oder der Kundenkommunikation zu widmen.
- Ungenutztes Einsparpotenzial: Die Lohnkosten für diese Zeitverschwendung summieren sich monatlich auf Tausende von Euro an reiner Ineffizienz – ganz zu schweigen von den Kosten durch Stillstände aufgrund übersehener, echter Vorfälle (Demurrage- und Detention-Gebühren).
Warum das Hochsetzen von Software-Schwellenwerten nicht funktioniert
Eine häufige Reflexreaktion auf Alert Fatigue ist die Neukalibrierung der Dashboard-Warnungen. IT-Abteilungen schlagen oft vor, die Toleranzmargen zu erweitern: Die Software generiert dann beispielsweise erst bei einer Verzögerung von 24 Stunden statt nach 4 Stunden eine Meldung. Diese Symptombekämpfung kaschiert jedoch lediglich die zugrunde liegenden Datenfehler.
Die Aufweichung der Alert-Regeln in einem TMS oder Control Tower akzeptiert verschmutzte Daten implizit als operativen Standard. Diese Toleranz untergräbt die Widerstandsfähigkeit der gesamten Supply Chain. Entscheidungen über alternative Routings, Konsolidierungen oder Cross-Docking basieren plötzlich auf ungenauen Zeitfenstern. Echte Skalierbarkeit (Scalability) erfordert jedoch strikte Protokolle und absolute Datengenauigkeit; Systeme, die mit bewusst eingebauten Margen rechnen, verlieren ihren prädiktiven Wert. Dieser Ratschlag bezieht sich spezifisch auf den Umgang mit administrativer Datenhygiene für Supply Chain Control Tower. Für reine Sensordatenströme gelten andere Gesetzmäßigkeiten.
Die Grenzen dieses Ansatzes: IoT-Sensordaten im Vergleich zur Dokumentation
Es besteht ein grundlegender Unterschied zwischen dem Rauschen von Hardware-Signalen und nachlässiger menschlicher Eingabe. IoT-Sensoren in Reefer-Containern messen kontinuierlich Variablen wie Temperatur oder Luftfeuchtigkeit. Diese unverarbeiteten Datenströme beinhalten natürliche Schwankungen, die etwa durch Abtauzyklen oder das Öffnen von Türen verursacht werden. Das iterative Kalibrieren und Glätten dieser Datenströme durch Algorithmen ist technisch absolut notwendig, um verwertbare Informationen zu erzeugen.
Eine ETA auf einem Frachtbrief, einem Zollzertifikat oder als Teil eines Incoterms weist hingegen keine natürliche Fluktuation auf. Ein Fehler in diesen Parametern ist ausschließlich das Resultat einer fehlerhaften oder fehlenden menschlichen Eingabe. Wo Sensordaten kalibriert werden müssen, bedarf es bei der manuellen Dateneingabe eines strikten Protokollmanagements.
Zurück zu den Grundlagen: Quelldaten für den Control Tower bereinigen
Das Fundament verlässlicher Supply-Chain-Dashboards liegt in der Zentralisierung und Straffung der Eingabeprozesse. Der Weg zu hundertprozentiger Data Accuracy erfordert eine konsequente Trennung zwischen automatisierten API-Datenverbindungen und der menschlichen Validierung von Dokumenten.
Wenn komplexe, unstrukturierte Zoll- und Versanddokumente via OCR (Optical Character Recognition) direkt und ohne Interpretationsprotokolle in eine Datenbank fließen, entstehen genau die Datenfehler, die zu den eingangs erwähnten Systemwarnungen führen. Technologien wie Robotic Process Automation (RPA) beschleunigen zwar die Übernahme strukturierter Felder, doch die logistische Realität ist geprägt von abweichenden PDF-Formaten, handschriftlichen Notizen auf CMR-Frachtbriefen und unvollständigen Packlisten. Wahre Datenhygiene verlangt in diesen Fällen ein straff geführtes Backoffice, das genau diese Ausnahmen abfängt, noch bevor die Rohdaten in das Logistik-Hauptsystem gelangen.
Angesichts des gravierenden Fachkräftemangels greift die Logistikbranche zunehmend auf strategische BPO-Lösungen zurück. Nearshoring bietet die dringend benötigte, strukturelle Datenverarbeitungskapazität – ohne jegliche Kompromisse bei der Compliance einzugehen. Indem die Dateneingabe an spezialisierte Teams außerhalb des primären operativen Betriebs ausgelagert wird, laufen die Backoffice-Prozesse in konstanter und bewährter Qualität weiter, während sich Ihre lokalen Disponenten wieder voll und ganz auf das tatsächliche Exception Handling der physischen Fracht konzentrieren können.
Standardisierung von Eingabeprotokollen in der Praxis
Um die Interpretation rauer Speditionsdokumente durch Backoffice-Mitarbeiter zu vereinheitlichen und die API mit absolut sauberen Daten zu speisen, sollten die folgenden Best Practices umgesetzt werden:
- Implementieren Sie eine digitale Quarantäne-Zone: Blockieren Sie Dokumente mit fehlenden oder nicht übereinstimmenden Schlüsselfeldern (wie z. B. abweichende Containernummern) für die automatisierte Übernahme, bis ein Mitarbeiter diese manuell verifiziert hat.
- Etablieren Sie Wenn-Dann-Matrizen für die Interpretation: Legen Sie für die Verarbeitung unstrukturierter Dokumente exakt fest, welches Datumsfeld federführend ist, falls ein Lieferant mehrere Transportdaten auf einem einzigen Formular vermerkt.
- Zentralisieren Sie die Bearbeitung von Ausnahmen: Stellen Sie sicher, dass Abweichungen in der Dokumentation über einen klar definierten Prozess abgewickelt werden. Nur so ist garantiert, dass die Eingabemethodik für problematische Dossiers identisch ist und nicht vom jeweiligen Bearbeiter abhängt.
- Kombinieren Sie RPA mit menschlicher Kontrolle (Human-in-the-Loop): Lassen Sie Skripte routinemäßige Datenextraktionen durchführen, beauftragen Sie jedoch hoch qualifizierte Fachkräfte mit der finalen Validierung kritischer Zoll- und Gefahrgutdokumente, bevor diese Datensätze den Control Tower erreichen.
Fehlerhafte und nicht validierte Dateneingaben in logistischen Backoffice-Systemen fungieren als Hauptantrieb für „Alert Fatigue“. Die Folgen sind verborgene Kosten und der Verlust der Reaktionsfähigkeit bei akuten Störungen in der Lieferkette. Die konsequente Bereinigung der Datenströme für den Control Tower sowie die strikte Trennung von administrativen Verzögerungen und physischen Hindernissen stoppen diese permanente Flut an Fehlalarmen. DataMondial, ein niederländisches, auf BPO spezialisiertes Unternehmen, begleitet diese operative Transformation aus drei vollständig EU-konformen Operations Centern in Rumänien. Kontaktieren Sie uns, um zu erfahren, wie ein Spezialist in Datenverarbeitung und Backoffice-Unterstützung Ihre internen Teams wirksam entlastet, höchste Datenqualität garantiert und Ihre Wettbewerbsposition nachhaltig und sicher stärkt.