De verborgen capaciteitsclaim van automatisering: Waarom uw AI-project onverwachts extra FTE vereist
De paradox van de geautomatiseerde backoffice
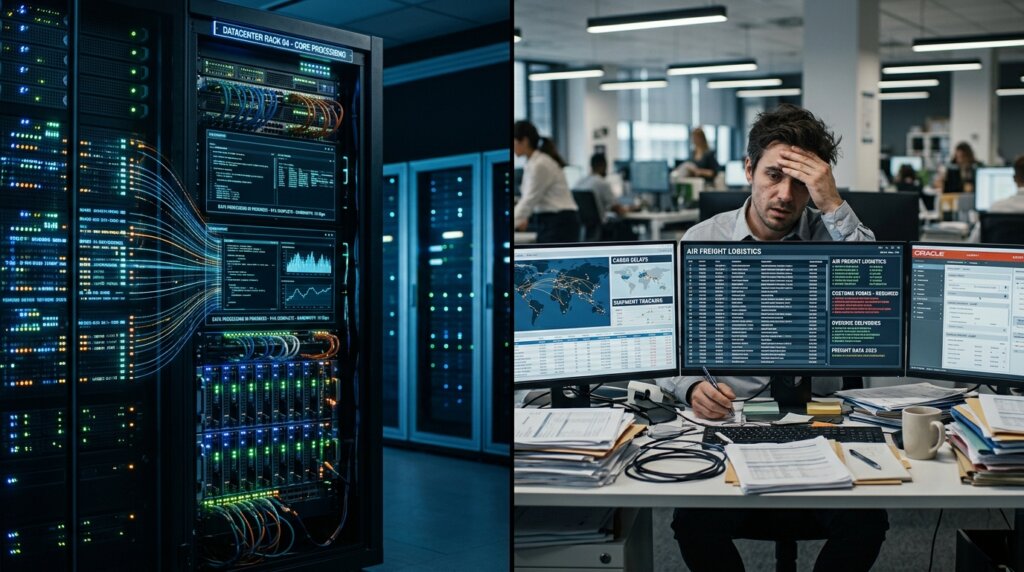
Automatisering belooft een lagere werkdruk en lagere operationele kosten voor de backoffice. De praktijk na een implementatie toont een ander beeld. Het geautomatiseerde systeem verwerkt het gros van de datastroom, maar genereert gelijktijdig een stroom aan complexe twijfelgevallen. Deze uitzonderingen eisen directe menselijke controle om het proces niet te laten vastlopen. Wat bedoeld was als een structurele ontlasting van de afdeling, creëert direct de noodzaak voor extra FTE om de output van de AI te bewaken. Het gericht oplossen van deze capaciteitsbottleneck door middel van professionele data validatie voor OCR, AI en Machine Learning voorkomt stagnatie in de operationele afhandeling.
De 80/20 valkuil bij ongestructureerde logistieke data
Bedrijfsprocessen die leunen op ongestructureerde logistieke data stranden op de laatste twintig procent van de documentenstroom. Algoritmes en RPA-systemen floreren bij gestandaardiseerde velden. Valt een document buiten die digitale kaders, dan weigert het systeem de verwerking. Een Bill of Lading, pakbon of douanecertificaat bevat in de praktijk afwijkende lay-outs, stempels over tekst heen of handgeschreven notities. Bij het extraheren van containernummers, zegelnummers of specifieke afleverbewijzen valt het systeem direct terug op menselijke validatie.
De verwerking van 100 standaarddocumenten via reguliere, handmatige data-entry volgt een voorspelbaar en constant ritme. De handmatige afhandeling van 20 geïsoleerde AI-uitzonderingen doorbreekt dit ritme en kost disproportioneel veel tijd en resources. Volledig gestructureerde stromen, zoals Electronic Data Interchange (EDI), ondervinden dit knelpunt niet omdat de datapunten daar op voorhand vastliggen. Externe, ongestructureerde stromen vereisen een continue, arbeidsintensieve vertaalslag.
De tijdsparadox van een geïsoleerde fout
Een medewerker die een regulier document van begin tot eind verwerkt, bouwt context op tijdens het lezen. Bij het beoordelen van één geïsoleerd twijfelgeval uit een AI-systeem ontbreekt deze context volledig. De medewerker moet het specifieke document openen, de redenering van het algoritme reconstrueren, de bron van de fout lokaliseren en de correctie doorvoeren. Deze gefragmenteerde handelswijze zorgt ervoor dat het valideren van een enkel afgewezen veld meer tijd kost dan de volledige handmatige invoer van datzelfde document.
Specifieke documenten versus gestructureerde EDI
Interne systeemstandaardisatie resulteert in frictieloze processen. Gestructureerde EDI-berichten stromen zonder fouten of tussenkomst door de systemen. De uitdaging ontstaat bij externe documentstromen die buiten uw invloedssfeer worden gegenereerd. Internationale ketens produceren een variëteit aan vracht- en transportdocumentatie waarbij iedere leverancier of douaneagent eigen formaten hanteert. Deze onvoorspelbaarheid maakt de externe datastroom uiterst foutgevoelig voor systemen die zijn gebouwd op rigide regels en verwachtingspatronen.
Cognitieve overbelasting transformeert uw backoffice
De introductie van automatisering verandert de aard van het werk op de werkvloer. Repetitieve taken verdwijnen, waardoor medewerkers zich vooral richten op complexe uitzonderingen en probleemoplossing. Deze taakverschuiving kan een nieuwe druk leggen op het bestaande personeel.
Wanneer systemen de voorspelbare taken overnemen, blijft een geconcentreerde hoeveelheid cognitief zwaar werk over. Hierdoor kan de alertheid en nauwkeurigheid afnemen, vooral wanneer medewerkers voortdurend uitzonderingen moeten beoordelen.
Daarnaast bestaat het risico dat medewerkers minder vertrouwd raken met de basis van processen die grotendeels zijn geautomatiseerd. Een constante stroom van uitzonderingsgevallen verhoogt bovendien de cognitieve belasting en kan leiden tot snellere uitputting. Hierdoor kan de kwaliteit van menselijke controles binnen een Human-in-the-Loop-proces onder druk komen te staan.
Van routine naar escalatiemanagement
Backoffice medewerkers transformeren van data-invoerders naar escalatiemanagers. Hun operationele functie is gereduceerd tot het fungeren als het vangnet voor falende algoritmes. Elke notificatie op het scherm betreft een afwijking die het systeem niet kan verwerken, waardoor de medewerker continu moet schakelen tussen uiteenlopende foutmeldingen, systemen en documentsoorten.
Mentale uitputting verlaagt data-accuratesse
Een afdeling die onafgebroken complexe uitzonderingen verwerkt, levert in op scherpte. Waar standaard data-entry momenten van lage cognitieve belasting kent, vereist de afhandeling van AI-twijfelgevallen uiterste focus. Deze constante mentale druk leidt er paradoxaal toe dat er meer fouten sluipen in de menselijke controle, wat ten koste gaat van de uiteindelijke data-accuratesse.
Continue model-training eist senior materiedeskundigen
Een AI-implementatie is geen project met een vastgestelde einddatum. De werkelijke operationele investering start na de integratie. Actueel onderzoek naar LLMOps benadrukt dat strategische capaciteitsplanning cruciaal is voor het behoud van een hoogwaardige output. Organisaties onderschatten structureel de verborgen kosten en de manuren die benodigd zijn om de data-accuratesse op lange termijn te waarborgen.
Format drift en de noodzaak voor hertraining
Documentformaten in de logistieke sector wijzigen voortdurend. Rederijen passen hun factuurvoorwaarden aan, douaneformulieren krijgen updates en nieuwe handelspartners introduceren afwijkende lay-outs. Door deze ‘format drift’ degraderen de prestaties van het algoritme over de tijd. Zonder menselijke kalibratie herkent het RPA-systeem de aangepaste velden niet meer. De benodigde hertraining kan enkel worden uitgevoerd door ervaren logistieke professionals die de materie doorgronden. Deze kalibratie haalt seniors weg bij hun kernactiviteiten en het operationeel aansturen van de processen.
Rekenvoorbeeld: de werkelijke kosten per validatie
De kosten van exception handling escaleren wanneer senior medewerkers verantwoordelijk zijn voor de correcties in een RPA-workflow.
Stel dat een geautomatiseerd proces dagelijks 50 foutmeldingen genereert die handmatige RPA-foutcorrectie vereisen:
Tijdsinvestering: Een senior materiedeskundige besteedt gemiddeld 4 minuten per foutmelding (inlezen, context bepalen, fout lokaliseren, systeem updaten). Dit resulteert in ruim 3,3 uur per dag aan pure exception handling.
Salariscomponent: Bij een intern tarief van €45 per uur voor een senior medewerker (inclusief werkgeverslasten), bedragen de directe kosten hiervan €148,50 per werkdag.
Operationele impact: Op maandbasis (22 werkdagen) kost het corrigeren van deze afgebakende groep uitzonderingen 72 uur en €3.267.
Deze directe uitsplitsing toont enkel de verwerkte tijd. De gederfde inkomsten door het weghalen van de expert bij strategische procesoptimalisatie brengen de werkelijke operationele kosten verder omhoog.
Besteed exception handling strategisch uit
De stap naar een renderende AI-investering vereist een scheiding tussen geautomatiseerde verwerking en complexe uitzonderingen. Behoud de snelheid van uw systemen door exception handling en de lastige validatie van AI-output niet intern te beleggen, maar uit te besteden aan een gespecialiseerd team binnen de EU. DataMondial levert als Nederlands BPO-bedrijf via nearshoring in Roemenië de schaalbaarheid, EU-compliance en gespecialiseerde capaciteit om uw logistieke AI-pilot schaalbaar te maken voor productie en operationele bottlenecks over te nemen. Ontlast uw eigen organisatie en laat onze experts uw datavalidatie accuraat en continu verwerken.