De ‘Appels en Peren’ Valkuil: Waarom Foutieve SKU-Matching uw E-commerce Marges Vernietigt
De impact van asymmetrische productdata op margebehoud
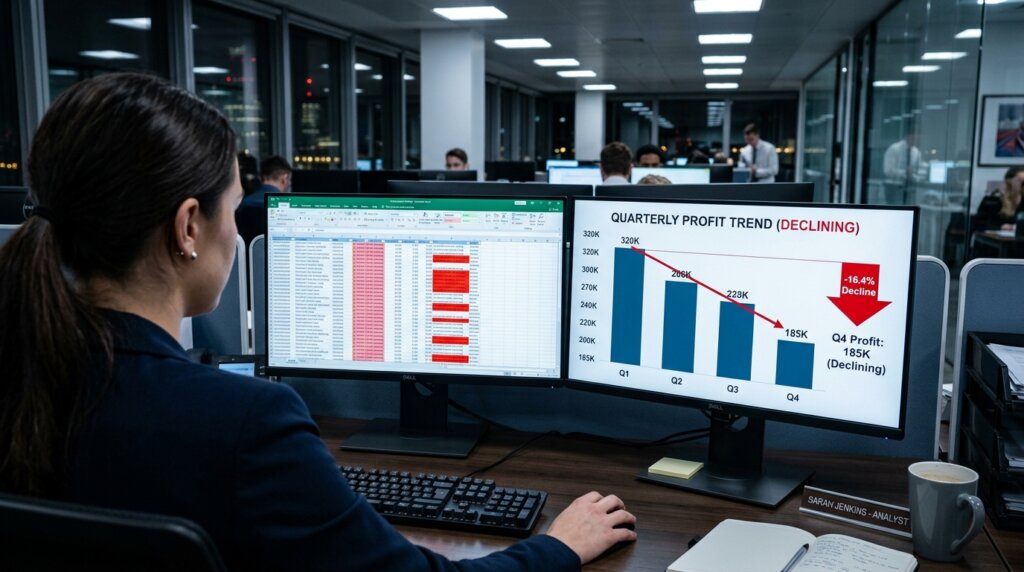
Foutieve productdata schaadt direct de winst-en-verliesrekening van een e-commerce onderneming. Wanneer systemen overgaan tot blinde prijsautomatisering op basis van ongeorganiseerde of asymmetrische data, ontstaan er afwijkingen die algoritmes zelfstandig niet corrigeren. Om dit te voorkomen is een robuuste aanpak voor webresearch en contentbeheer essentieel voor het behoud van uw concurrentiepositie. Dit probleem concentreert zich bij actieve wederverkoop van bestaande merken, waarbij catalogi van verschillende aanbieders met elkaar concurreren. In markten die uitsluitend opereren met unieke, gepatenteerde single-SKU producten speelt dit risico niet, aangezien er geen externe vergelijkingsdata bestaat.
De financiële schade van geautomatiseerde fouten is direct kwantifiableerbaar. Stel dat een algoritme is ingesteld om altijd de laagste marktprijs te evenaren. Verkopers A biedt een product aan als 3-pack. Verkoper B biedt exact hetzelfde product aan als 1-pack, geprijsd op een derde van de waarde. Het algoritme van verkoper A detecteert via een gedeeltelijke SKU-overeenkomst of een algemene producttitel de prijs van verkoper B en classificeert dit als een directe concurrent.
Het systeem verlaagt vervolgens de verkoopprijs van het 3-pack naar de prijs van het 1-pack. Omdat het algoritme de logische context van verpakkingsafwijkingen mist zodra specifieke parameters niet exact overeenkomen, blijft deze gereduceerde prijs actief. Als deze situatie zeven dagen onopgemerkt blijft in een hoog-volume categorie, levert de verkoper de producten met verlies aan consumenten uit, wat direct ten koste gaat van de nettowinst.
Onterechte prijsdalingen zonder volume-toename
De publicatie Limitations of AI Product Matching in E-Commerce stelt dat dergelijke matching-fouten het fundament onder rendabele prijsstrategieën wegslaan. In het rekenvoorbeeld van het 3-pack dat voor de prijs van een 1-pack wordt verkocht, incasseert de verkoper direct de inkoopkosten van twee eenheden als volledig verlies per transactie, exclusief de gemaakte verzendkosten.
Het verlies wordt versterkt door het ontbreken van een volume-toename die de margedaling normaal gesproken compenseert. Consumenten kopen in dit scenario geen grotere aantallen; zij profiteren simpelweg van een systeemfout. De nettowinst krimpt zonder dat hier een strategisch marktaandeel tegenover staat. De publicatie Product Data Matching for E-commerce: AI Solutions 2026 bevestigt dat blinde vergelijkingstools zonder gestructureerde datalaag resulteren in een negatieve ROI op geautomatiseerde repricing-campagnes.
Verborgen voorraad door schijnbare out-of-stock fouten
Asymmetrische data leidt aan de andere kant van het spectrum tot onterechte voorraadtekorten. Fysieke goederen liggen klaar voor verzending in het warehouse, maar zijn digitaal onverkoopbaar.
Dit ontstaat wanneer inkoopsystemen en verkoopkanalen niet dezelfde matching-id’s hanteren. Een product ontvangt bij inslag in het Warehouse Management System (WMS) een interne code die door een gebrekkige mapping niet correspondeert met de actieve SKU op de frontend van de webshop. Dit vormt vaak de bottleneck bij de goedereningang waar fysieke realiteit en digitale data uit elkaar lopen. Resultaat: de voorraad blijft op nul staan. De analyse in het rapport Inventory Discrepancies & SKU Mismatches: Causes, Fixes and Prevention wijst uit dat het ontbreken van harde koppelingen tussen backoffice-data en e-commerce platformen leidt tot het onnodig vasthouden van werkkapitaal in magazijnen, terwijl systemen onterecht nieuwe inkooporders genereren.
Drie katalysatoren van SKU matching problemen in catalogi
Data faalt op specifieke, operationele momenten binnen de toeleveringsketen. Inkoopprocessen en handmatige datainvoer zijn hierbij de primaire momenten waar asymmetrie ontstaat. Een schone catalogus vereist dat de input aan de basis foutloos is. Zodra vervuilde data het e-commerce ecosysteem binnenkomt, verspreiden de fouten zich direct naar repricing-tools, voorraadsystemen en financiële dashboards.
Verpakkingsupdates en EAN-recycling door leveranciers
Een bekende pijnpunt in catalogusbeheer ontstaat bij de fabrikant. Volgens de richtlijnen beschreven in GS1 Barcode Fundamentals hoort elke wijziging in een product, hoe klein ook, te resulteren in een nieuwe EAN-code (European Article Number). In de praktijk recyclen leveranciers geregeld bestaande barcodes voor vernieuwde verpakkingen of licht gewijzigde versies, zoals een product met aangepaste ingrediënten.
Wanneer een oude EAN aan een nieuw product blijft hangen, verstoort dit e-commerce systemen. Een prijsvergelijker zoekt op EAN en koppelt de historische prijsdata van de oude versie, die mogelijk door concurrenten met korting wordt uitverkocht, aan de vernieuwde versie die tegen de volle marge verkocht hoort te worden. Zoals uiteengezet in Fuzzy Matching Algorithms for SKU Alignment, raken algoritmes gedesoriënteerd wanneer het primaire referentiepunt, de unieke identifier, zijn unieke eigenschap verliest.
Ontbrekende normalisatie van producteenheden
Cross-border e-commerce dwingt systemen om om te gaan met internationale meetverschillen. Wanneer een webshop producten inkoopt uit de Verenigde Staten en verkoopt in Europa, fluctueren eenheden tussen imperiaal en metrisch. Flessen van 16 fluid ounces moeten vergeleken worden met flessen van een halve liter.
Als inkomende feeds geen normalisatielaag passeren die gewichten en volumes op een uniforme basis standaardiseert, ontstaat er ruis. Conversiefouten zorgen ervoor dat een algoritme een 500 milliliter verpakking als een totaal ander product beschouwt dan exact dezelfde vloeistof aangeduid als 16.9 ounces. Core Architecture: Catalog Matching Fundamentals for Price Intelligence toont aan dat het ontbreken van geautomatiseerde eenheidsconversie resulteert in onvolledige prijsvergelijkingen, omdat concurrerende aanbiedingen systematisch over het hoofd worden gezien.
Geforceerde clustering van generieke productvarianten
Verzamel-SKU’s vormen een operationeel risico. Soms kiezen databeheerders ervoor om diverse kleurnuances of lichte modelwijzigingen te clusteren onder één hoofd-SKU om de catalogus visueel overzichtelijk te houden. Dit ontneemt specifieke productvarianten hun digitale identiteit.
In geautomatiseerde datafeeds is een specifiek model vereist om voorraad en prijs per stuk te beheren. Krijgt een consument een generieke ‘diverse kleuren’ optie zonder specifieke variant-SKU, dan faalt het voorraadsysteem bij het afboeken. Om deze oorzaken preventief in te dammen, hanteren operationele teams een controle op de volgende drie datapunten:
- Verpakkingstype (Aantal consumenteneenheden per verzendeenheid)
- Producteenheid (Gestandaardiseerde metrische invoer)
- Releasejaar (Identificatie van stille updates onder dezelfde EAN)
De blinde vlek van geautomatiseerde prijsmonitoren
Volledig vertrouwen op technologische prijsmonitoren creëert kwetsbaarheden. Pure AI-oplossingen en scrapers implementeren regels sneller dan een mens, maar missen het analytisch vermogen bij ambiguïteit. Als een dataprobleem zich voordoet op de bron, schaalt de automatisering deze fout ongehinderd door de volledige operationele structuur.
Voor assortimenten onder de 100 producten weegt de investering in uitgebreide webresearch en handmatige validatie zelden op tegen het resultaat. Handmatige controle is daar direct uitvoerbaar. Bij duizenden SKU’s, stelt Core Architecture: Catalog Matching Fundamentals for Price Intelligence, falen geautomatiseerde systemen zonder een structurele hybride processen waarbij technologie en menselijke beoordeling samenwerken.
Tekst versus beeldinterpretatie in scraping
Standaard scraping tools zijn gebaseerd op string-vergelijking. Zij scannen het internet, lezen tekst en vergelijken titels en beschrijvingen. De technische beperking hierin is de onmogelijkheid om visuele productverschillen in afbeeldingen accuraat te interpreteren.
Dynamische producttitels bij concurrerende verkopers misleiden de basisregels van code. Een concurrent kan een vermelding online zetten met de titel ‘Product X – 50ML’ terwijl de bijgevoegde foto een actieverpakking toont met twee flessen. Het algoritme leest de tekst, ziet geen multipack vermelding en creëert valse prijsmatches, zogenaamde ‘phantom comparisons’. Het rapport Limitations of AI Product Matching in E-Commerce beschrijft hoe de uitsluiting van beeldcontext in scrapers de betrouwbaarheid van de gegenereerde data drastisch verlaagt.
De noodzaak van een hybride validatielaag
Een stabiel fundament voor price intelligence vereist webresearch door professionals. Algoritmes identificeren potentiële matches, markeren afwijkingen in prijs met hoge marges en signaleren onbekende EAN-codes. In plaats van deze data direct te vertalen in acties op de e-commerce frontend, functioneert dit als input voor een menselijke validatielaag.
Getrainde dataspecialisten beoordelen de geflagde items, corrigeren de verkeerd geïnterpreteerde verpakkingseenheden en scheiden de oude productversies van de nieuwe releases. Deze opschoning dicht de foutenmarge in grootschalige catalogi en garandeert dat de uiteindelijke data die de WMS- en e-commerceplatformen voedt, feitelijk correct is.
Foutieve SKU-matching is niet louter een technisch ongemak, het is een aanwijsbare oorzaak van margeverlies en kapitaalvernietiging in e-commerce. Door EAN-recycling en tekortschietende normalisatie falen algoritmes bij het detecteren van de juiste prijs en voorraad, wat leidt tot onnodige prijsdumping en blokkades in verkoopbare goederen. Het implementeren van een hybride validatielaag stopt deze daling door geautomatiseerde detectie te combineren met scherp, menselijk inzicht. Voor een succesvolle strategie kunt u kiezen voor prijzen en concurrentiedata structureel monitoren om grip te houden op uw marktpositie.
Voor organisaties met complexe datastromen biedt DataMondial schaalbare oplossingen via hoogwaardige BPO-dienstverlening. Vanuit EU-compliant nearshoring faciliteiten in Roemenië neemt een team van specialisten de grootschalige opschoning, webresearch en structurering van e-commerce catalogi over op het gebied van datamanagement en contentbeheer. Verhoog uw data accuracy, verlaag interne operationele kosten en implementeer een feilloos hybride proces voor langdurige stabiliteit. Neem contact op met DataMondial om de actuele asymmetrie in uw productdata in kaart te brengen.